IOI 2011 - Parrots
Xem PDFYanee rất yêu thích chim. Kể từ khi đọc về giao thức IP truyền bằng chim đưa thư (IP over Avian Carriers, viết tắt là IPoAC), cô dành nhiều thời gian huấn luyện một đàn vẹt thông minh để mang thông điệp đi xa.
Ước mơ của Yanee là dùng đàn chim để gửi một thông điệp \(M\) đến một vùng đất xa xôi. Thông điệp \(M\) là một dãy gồm \(N\) số nguyên, không nhất thiết phân biệt, mỗi số nằm trong khoảng từ \(0\) đến \(255\), kể cả hai đầu mút. Yanee có \(K\) chú vẹt được huấn luyện đặc biệt. Tất cả đều trông giống nhau nên cô không thể phân biệt chúng. Mỗi chú vẹt có thể nhớ một số nguyên từ \(0\) đến \(R\), kể cả hai đầu mút.
Ban đầu, Yanee thử một cách đơn giản: cô cẩn thận thả từng chú vẹt ra khỏi lồng; trước khi mỗi chú bay đi, cô dạy nó một số trong dãy thông điệp, theo đúng thứ tự. Tiếc rằng cách này không thành công. Cuối cùng, tất cả các chú vẹt đều đến đích, nhưng thứ tự đến không nhất thiết giống thứ tự xuất phát. Yanee có thể khôi phục các số đã gửi nhưng không thể sắp xếp chúng về đúng thứ tự.
Để thực hiện ước mơ, Yanee cần một cách tốt hơn và muốn nhờ bạn giúp đỡ. Với thông điệp \(M\), cô vẫn thả từng chú vẹt như trước. Bạn cần viết chương trình thực hiện hai thao tác riêng biệt:
- Đọc thông điệp \(M\) và biến đổi nó thành một dãy gồm nhiều nhất \(K\) số nguyên từ \(0\) đến \(R\) để dạy cho các chú vẹt.
- Đọc danh sách các số nguyên từ \(0\) đến \(R\) nhận được khi các chú vẹt đến đích, rồi biến đổi danh sách ấy về thông điệp \(M\) ban đầu.
Có thể giả sử mọi chú vẹt luôn đến đích và nhớ chính xác số được giao. Các chú vẹt có thể đến theo thứ tự bất kỳ. Yanee chỉ có \(K\) chú vẹt, vì vậy dãy số bạn tạo ra không được chứa quá \(K\) phần tử.
Yêu cầu
Hãy viết hai hàm riêng biệt: một hàm dùng ở phía gửi (bộ mã hóa) và một hàm dùng ở phía nhận (bộ giải mã). Quá trình tổng thể được minh họa dưới đây: thông điệp ban đầu \(M\) được mã hóa thành \(E\), thứ tự bị xáo trộn thành \(X\), rồi được giải mã để thu lại đúng \(M\).
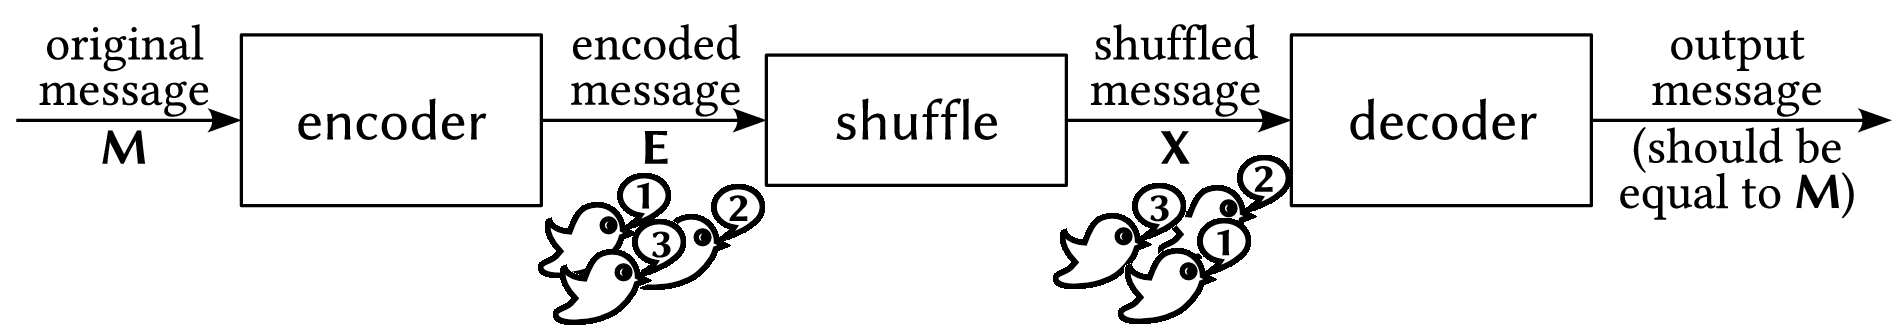
Trên LQDOJ, nộp một tệp mã nguồn C++ cài đặt cả encode và decode, không cài đặt hàm main. Hai vai trò được chạy trong hai tiến trình riêng biệt: tiến trình mã hóa chỉ được gọi encode, còn tiến trình giải mã chỉ được gọi decode. Biến toàn cục, biến static và mọi trạng thái trong bộ nhớ của tiến trình mã hóa không được chia sẻ với tiến trình giải mã.
Thông tin mà phía giải mã nhận được là N, số lượng L và các giá trị trong X do trình chấm truyền vào. Dãy X có thể là bất kỳ hoán vị nào của các số đã gửi, kể cả khi có các giá trị trùng nhau. Vì vậy, thứ tự gọi send không thể dùng để truyền thông tin; việc giải mã phải đúng với mọi thứ tự nhận. Cách nộp một tệp nguồn này giữ nguyên ý nghĩa của hai vai trò trong đề gốc.
Các khai báo giao diện gốc dưới đây được giữ nguyên:
// encoder.h
void encode(int N, int M[]);

// decoder.h
void decode(int N, int L, int X[]);
Trình chấm cung cấp hai hàm sau để bạn gọi:
// encoderlib.h
void send(int a);

// decoderlib.h
void output(int b);
Hàm encode(N,M) nhận độ dài thông điệp N và mảng một chiều M gồm \(N\) số nguyên, với \(0 \le M[i] \le 255\) cho mọi \(0 \le i < N\). Hàm phải mã hóa thông điệp thành một dãy số nguyên trong đoạn \([0,R]\) để gửi bằng vẹt. Để báo dãy này, encode phải gọi send(a) một lần cho mỗi số nguyên a muốn giao cho một chú vẹt.
Hàm decode(N,L,X) nhận độ dài thông điệp ban đầu N, độ dài thông điệp nhận được L (số vẹt đã gửi), và mảng một chiều X gồm \(L\) số nguyên nhận được. Các phần tử X[i], với \(0 \le i < L\), chính là các số do encode tạo ra, nhưng có thể đã bị đổi thứ tự. Hàm phải khôi phục thông điệp ban đầu và báo kết quả bằng cách gọi output(b) cho từng số nguyên b trong thông điệp đã giải mã, theo đúng thứ tự.
\(R\) và \(K\) không được truyền vào các hàm. Giá trị của chúng được quy định trong từng nhóm bên dưới. Để giải đúng một nhóm, chương trình phải thỏa mãn tất cả các điều kiện sau:
- Mọi số nguyên do
encodegửi đều nằm trong phạm vi quy định của nhóm. - Số lần
encodegọisendkhông vượt quá \(K\) của nhóm. Lưu ý rằng \(K\) phụ thuộc vào độ dài thông điệp. decodekhôi phục đúng thông điệp ban đầu và gọioutputđúng \(N\) lần, lần lượt với các giá trịM[0],M[1], ...,M[N-1].
Ở nhóm cuối, điểm số phụ thuộc vào tỉ số giữa độ dài thông điệp đã mã hóa và độ dài thông điệp ban đầu.
Ràng buộc
Trong mọi nhóm, các phần tử của thông điệp ban đầu là số nguyên từ \(0\) đến \(255\), trừ ràng buộc chặt hơn của nhóm \(1\). Phạm vi số được gửi luôn bao gồm cả \(0\) và \(R\).
Phân nhóm
| Nhóm | Điểm | Độ dài và nội dung thông điệp | \(R\) | Số lần gọi send tối đa |
|---|---|---|---|---|
| 1 | 17 | \(N=8\); mỗi phần tử của \(M\) là \(0\) hoặc \(1\). | \(65\,535\) | \(K=10N\) |
| 2 | 17 | \(1 \le N \le 16\). | \(65\,535\) | \(K=10N\) |
| 3 | 18 | \(1 \le N \le 16\). | \(255\) | \(K=10N\) |
| 4 | 29 | \(1 \le N \le 32\). | \(255\) | \(K=10N\) |
| 5 | Tối đa 19 | \(16 \le N \le 64\). | \(255\) | \(K=15N\) |
Cách tính điểm nhóm 5. Với bộ dữ liệu \(t\), gọi \(N_t\) là độ dài thông điệp ban đầu và \(L_t\) là độ dài thông điệp đã mã hóa. Đặt:
Giá trị lớn nhất được lấy trên tất cả các bộ dữ liệu của nhóm \(5\). Điểm của nhóm được tính như sau:
- Nếu \(P \le 5\), bạn được trọn \(19\) điểm.
- Nếu \(5 < P \le 6\), bạn được \(18\) điểm.
- Nếu \(6 < P \le 7\), bạn được \(17\) điểm.
- Nếu \(7 < P \le 15\), bạn được số điểm sau, làm tròn xuống đến số nguyên gần nhất:
- Nếu \(P>15\) hoặc có bất kỳ kết quả nào không đúng, bạn được \(0\) điểm.
Một lời giải hợp lệ cho bất kỳ nhóm nào từ \(1\) đến \(4\) cũng giải được tất cả các nhóm đứng trước nó. Tuy nhiên, do giới hạn \(K\) lớn hơn, một lời giải hợp lệ cho nhóm \(5\) có thể không giải được các nhóm \(1\) đến \(4\). Có thể dùng cùng một lời giải để giải tất cả các nhóm.
Giới hạn và giao diện
Trong môi trường chấm của IOI 2011, bài làm được biên dịch thành hai chương trình e và d, chạy riêng biệt. Cả mô-đun mã hóa lẫn mô-đun giải mã đều được liên kết vào mỗi chương trình, nhưng e chỉ gọi encode, còn d chỉ gọi decode.
Chương trình e thực hiện 50 lần gọi encode trong 2 giây CPU. Chương trình d thực hiện 50 lần gọi decode trong 2 giây CPU. Giới hạn bộ nhớ là 256 MB. Không có giới hạn riêng cho ngăn xếp; bộ nhớ ngăn xếp được tính vào tổng bộ nhớ sử dụng.
Trong bộ API gốc của IOI 2011, thư mục cài đặt là parrots/. Thí sinh cài đặt encoder.c, encoder.cpp hoặc encoder.pas, và decoder.c, decoder.cpp hoặc decoder.pas. Giao diện phía thí sinh là encoder.h hoặc encoder.pas, cùng với decoder.h hoặc decoder.pas. Giao diện phía trình chấm là encoderlib.h hoặc encoderlib.pas, cùng với decoderlib.h hoặc decoderlib.pas. Trình chấm mẫu là grader.c, grader.cpp hoặc grader.pas.
Trong cách tổ chức hai tệp của bộ API gốc, với C/C++, cả trình chấm mẫu lẫn trình chấm chính thức đều liên kết encoder.c[pp] và decoder.c[pp] cùng với trình chấm. Vì vậy, cần khai báo các biến toàn cục trong mỗi tệp là static để tránh xung đột với biến trong tệp khác.
Trình chấm mẫu trong bộ API gốc thực hiện hai lượt riêng biệt. Trong mỗi lượt, nó gọi encode với dữ liệu đã cho rồi gọi decode với kết quả của encode. Ở lượt đầu, nó giữ nguyên thứ tự các số đã mã hóa. Ở lượt thứ hai, nó đổi chỗ các số ở các vị trí lẻ và chẵn kề nhau. Trình chấm chính thức áp dụng nhiều kiểu hoán vị khác nhau. Bạn có thể thay đổi cách xáo trộn của trình chấm mẫu bằng cách sửa hàm shuffle trong C/C++ hoặc Shuffle trong Pascal.
Trình chấm mẫu kiểm tra cả phạm vi giá trị lẫn độ dài dữ liệu mã hóa. Mặc định, nó kiểm tra các số nằm trong đoạn \([0,65\,535]\) và độ dài không quá \(10N\). Bạn có thể thay đổi các hằng số channel_range (chẳng hạn từ \(65\,535\) thành \(255\)) và max_expansion (chẳng hạn từ \(10\) thành \(15\) hoặc \(7\)).
Dữ liệu vào
Trình chấm mẫu đọc các tệp grader.in.1, grader.in.2, ... theo định dạng:
- Dòng \(1\): \(N\).
- Dòng \(2\): \(N\) số
M[0],M[1], ...,M[N-1].
Dữ liệu ra
Các tệp kết quả mẫu grader.expect.1, grader.expect.2, ... đều chứa đúng dòng Correct. khi kết quả giải mã đúng và dữ liệu mã hóa thỏa mãn các giới hạn mà trình chấm mẫu kiểm tra.
Ví dụ
Ví dụ 1
Input
3
10 30 20
Output
Correct.Giải thích
Giả sử \(N=3\) và M = {10,30,20}. Bằng một phương pháp nào đó, encode(N,M) có thể mã hóa thông điệp thành dãy \((7,3,2,70,15,20,3)\). Để báo dãy ấy, hàm gọi:
send(7)
send(3)
send(2)
send(70)
send(15)
send(20)
send(3)
Giả sử khi tất cả các chú vẹt đến đích, danh sách các số ghi lại được là \((3,20,70,15,2,3,7)\). Khi đó, decode được gọi với \(N=3\), \(L=7\) và X = {3,20,70,15,2,3,7}. Hàm phải tạo ra thông điệp ban đầu \((10,30,20)\) bằng các lời gọi:
output(10)
output(30)
output(20)
Ví dụ 2
Input
8
1 0 1 0 0 1 1 0
Output
Correct.Ví dụ 3
Input
10
1 1 2 1 2 3 1 7 10 9
Output
Correct.Nguồn
IOI 2011, ngày thi 2, Pattaya, Thái Lan. Đề Parrots, bản tiếng Anh 1.3: PDF chính thức. Nội dung được dịch từ đề chính thức; tất cả các hình minh họa đều lấy từ đề chính thức. Giao diện C/C++ và dữ liệu của trình chấm mẫu được đối chiếu với bộ API gốc.
Kỳ thi:
- IOI 2011 - Ngày 2 (26 Tháng bảy, 2011)
Bình luận