Hướng dẫn cho Google Code Jam 2020 - Emacs++
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Test Set 1
Tóm tắt: Hãy xem các dấu ngoặc như một cây, trong đó cha của một vị trí là cặp dấu ngoặc gần nhất chứa vị trí đó. Đi tới tổ tiên chung thấp nhất, rồi đi ngược xuống cây.
Ý tưởng đầu tiên có thể là chạy tìm kiếm theo chiều rộng cho từng truy vấn rồi cộng các giá trị lại. Tiếc rằng cách này quá chậm đối với các giới hạn đã cho. May mắn là ta có thể tận dụng cấu trúc chương trình Lisp++ và việc mọi chi phí di chuyển đều bằng 1 (sang trái, sang phải hoặc tới dấu ngoặc khớp; để dễ giải thích, ta gọi sang trái hoặc phải là "đi bộ", còn tới dấu ngoặc khớp là "nhảy").
Ta cần hai nhận xét tương đối đơn giản trước khi bàn về lời giải dự kiến. Thứ nhất, hầu như ta luôn muốn nhảy thay vì đi bộ bên trong một cặp ngoặc. Nếu đang ở một đầu cặp ngoặc và việc nhảy tới đầu kia không khiến ta "vượt quá" đích, ta nên nhảy thay vì đi bộ tới đó. Thứ hai, nếu một cặp ngoặc chứa cả vị trí hiện tại lẫn đích, ta không bao giờ nên đi ra ngoài cặp ấy.
Chỉ với hai nhận xét này, hãy xét đường đi tối ưu cho một truy vấn cụ thể. Xét cặp dấu ngoặc gần nhất chứa cả điểm bắt đầu lẫn điểm kết thúc:
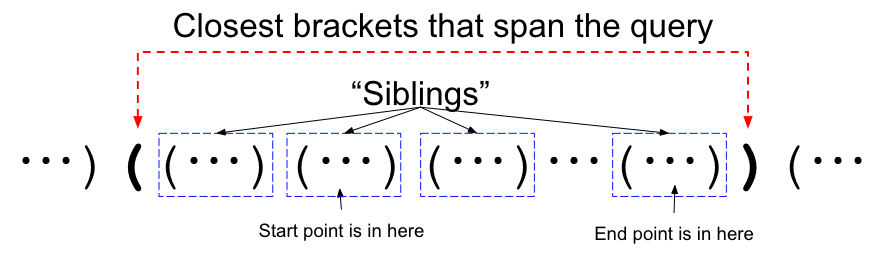
Đường đi tối ưu phải đi "lên" tới tầng này:
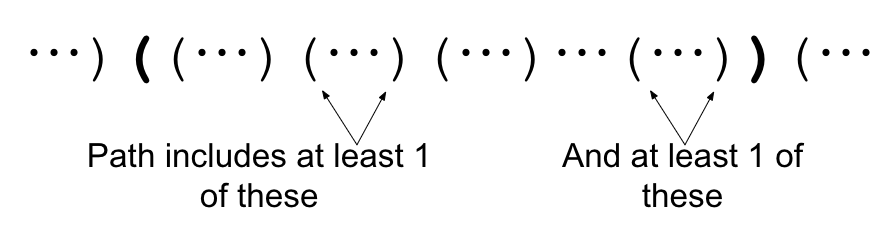
Khi đã ở tầng này, ta nhảy dọc tầng trên cùng của các nút anh em cho tới cặp ngoặc của điểm cuối, rồi đi "xuống" tới đáp án. Ta có thể nhảy sang trái hoặc phải (một hướng sẽ vòng qua khi chạm đầu mút cặp ngoặc), nên phải xét cả hai và lấy giá trị nhỏ nhất.
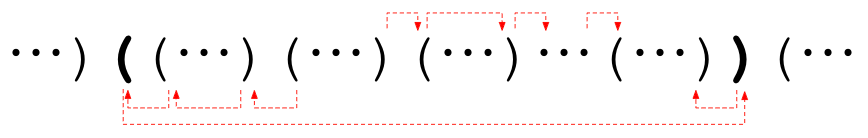
Tới đây, ta xem chương trình Lisp++ như một cây, trong đó cha là cặp ngoặc gần nhất bao lấy ta. Một dấu ngoặc của nút cha luôn gần hơn dấu còn lại một cách nghiêm ngặt, nên trên đường "lên" hoặc "xuống" cây, ta luôn tới dấu ngoặc cha đó trước. Tầng trên cùng chính là tổ tiên chung thấp nhất trên cây, có thể tính trong \(O(\log K)\).
Test Set 2
Tóm tắt: (1) Tìm hai cặp ngoặc chia chương trình Lisp++ thành 4 phần rời nhau. (2) Tính đường đi ngắn nhất từ các điểm chia để trả lời truy vấn đi từ miền này sang miền khác. (3) Đệ quy trên 4 miền con.
Đối với Test Set 2, một số tính chất đã dùng không còn đúng. Cụ thể, đi ra ngoài LCA mô tả ở trên giờ có thể là tối ưu. Có hai lớp lời giải chính cho test set này. Một lớp sửa đổi thuật toán LCA ở trên. Ta sẽ trình bày lớp còn lại vì nó minh họa một thuật toán ít truyền thống hơn. Thay vì trả lời từng truy vấn, ta sẽ giải chúng theo lô.
Tính chất then chốt là khả năng chia chương trình Lisp++ thành nhiều phần (gần như) độc lập. Trước hết là một nhận xét quan trọng. Xét một cặp ngoặc khớp nhau. Cách duy nhất để đi từ bên trong ra bên ngoài là đi qua chính các dấu ngoặc ấy. Những dấu ngoặc dùng để chia dữ liệu vào thành các phần sẽ được gọi là dấu ngoặc đặc biệt.
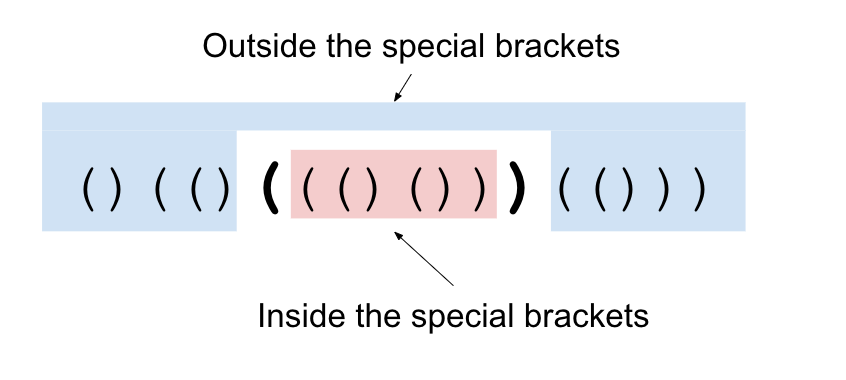
Ta có thể trả lời truy vấn theo cách khác. Thay vì tính khoảng cách từ đầu tới cuối truy vấn, ta tính khoảng cách từ mỗi dấu ngoặc đặc biệt tới điểm đầu và từ các dấu ngoặc đặc biệt tới điểm cuối. Vì mọi đường đi ngắn nhất phải qua một dấu ngoặc đặc biệt, tổng hai khoảng cách này là đáp án truy vấn.
Thoạt nhìn điều này có vẻ không giúp ích. Tuy nhiên, ta có thể đồng thời tính đáp án cho mọi truy vấn đi từ trong ra ngoài cặp ngoặc! Chỉ cần tính khoảng cách từ các dấu ngoặc đặc biệt tới mọi vị trí (chẳng hạn bằng thuật toán Dijkstra) rồi dùng phương pháp trên.
Còn các truy vấn có cả đầu và cuối ở bên trong (hoặc cả hai ở bên ngoài) thì sao? Đường ngắn nhất có thể đi qua các dấu ngoặc đặc biệt đã chọn, nên ta ghi nhận đáp án tiềm năng đó. Sau đó, ta chỉ còn quan tâm tới các đường không dùng dấu ngoặc đặc biệt.
Do đó, ta tách bài toán thành hai bài toán con: phần "bên trong" và phần "bên ngoài". Chia truy vấn vào phần thích hợp rồi giải đệ quy từng phần. Có thể loại bỏ hoàn toàn dấu ngoặc đặc biệt vì đã biết đáp án cho mọi truy vấn liên quan tới chúng. Tuy nhiên, cách này chưa chắc đủ nhanh. ☹ Nếu chọn dấu ngoặc đặc biệt tồi khiến phần "bên trong" luôn là chuỗi ngắn, thuật toán cần \(O(K^2)\). Để nhanh, cả hai bài toán con phải có kích thước xấp xỉ một nửa ban đầu. Thêm heuristic và chọn cặp ngoặc ngẫu nhiên có thể nhanh hơn về trung bình, nhưng không bảo đảm vượt dữ liệu. Điều chỉnh nhỏ dưới đây sẽ giải quyết vấn đề!
Thay vì chia thành 2 phần, ta chia thành 4 phần. Cha của một cặp ngoặc là cặp ngoặc gần nhất bao lấy nó. Chia bằng một cặp ngoặc và cặp ngoặc cha sẽ tạo 4 phần. Không thể đi từ các phần phía trong sang phía bên kia mà không qua một trong hai cặp đặc biệt, vì cặp cha là cặp gần nhất với cặp ban đầu cho phép thực hiện việc đó.
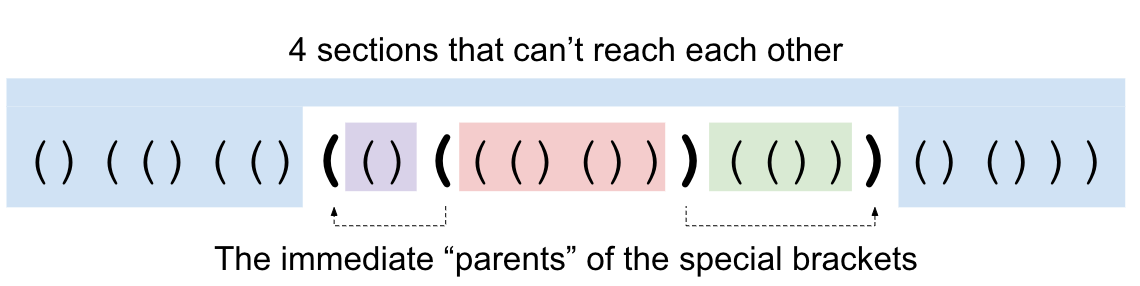
Thay đổi nhỏ này có vẻ làm mọi thứ phức tạp hơn, nhưng giải quyết vấn đề trên! Trước hết, thêm một cặp ngoặc bên ngoài chuỗi và đặt \(L_i\), \(R_i\), \(P_i\) của nó thành vô cực. Khi đó mọi cặp ngoặc đều có cha, trừ cặp vô cực mới thêm.
Hãy xét mọi cặp ngoặc có khoảng trải (từ ngoặc mở tới ngoặc đóng, kể cả hai đầu) chứa dấu ngoặc ở giữa (có hai dấu ngoặc "ở giữa"; chọn cái nào cũng được). Gọi chúng là các "cặp ngoặc trên đường giữa". Chúng tạo thành một chuỗi, trong đó mỗi cặp lồng dưới một cặp khác trên đường giữa, hoặc là cặp ngoài cùng đã thêm. Các cặp này có những tính chất hữu ích.
Xét chúng từ ngoài vào trong, khoảng trải chuyển từ chứa hơn một nửa số ký tự (cặp ngoài thêm vào trải toàn chuỗi) sang chứa nhiều nhất một nửa. Chúng luôn nhỏ dần và cặp trong cùng trải nhiều nhất nửa số ký tự. Xét "điểm chốt": hai cặp liên tiếp trên đường giữa, trong đó một cặp trải hơn nửa và có nút con trực tiếp cũng trên đường giữa, trải nhiều nhất nửa. Lấy hai cặp này khỏi chuỗi tạo 4 phần rời nhau (có thể rỗng), không phần nào chứa hơn nửa số ký tự.
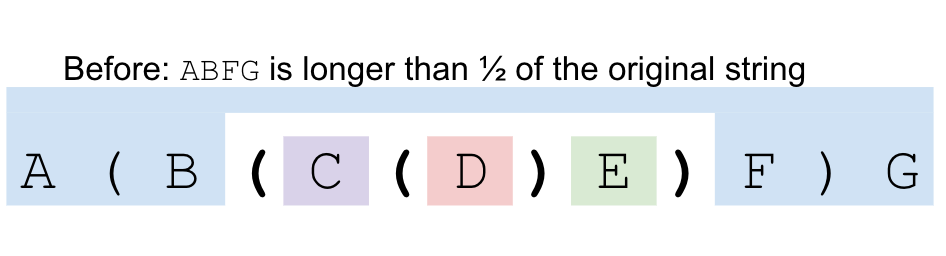
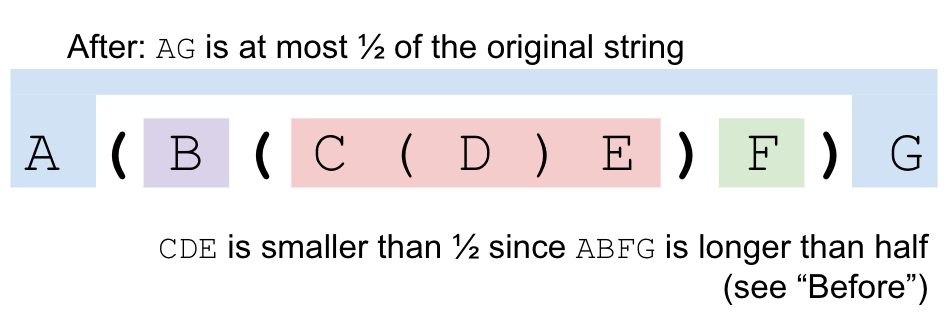
Tại sao? Giả sử các dấu ngoặc có dạng A ( B ( C ) D ) A. Vì cặp ngoài trải hơn nửa nên miền A chứa ít hơn nửa số ký tự. Cặp trong cắt qua hoặc chạm đường giữa, nên B và D chứa ít hơn nửa. Cuối cùng, C chứa nhiều nhất nửa (ta chọn riêng C vì nó là cặp đầu tiên trên đường giữa chứa nhiều nhất nửa số ký tự). Không thể đi giữa hai miền mà không qua một dấu ngoặc đặc biệt. Cụ thể, không thể đi giữa B và D vì cặp đặc biệt ngoài là cha của cặp đặc biệt trong.
Vì vậy, ta tìm hai cặp ngoặc đặc biệt để chia, dùng Dijkstra trả lời các truy vấn giữa những miền khác nhau (đồng thời tính đáp án tiềm năng cho các truy vấn không như vậy), rồi đệ quy vào 4 bài toán con. Mỗi lần đệ quy giảm độ dài chuỗi còn một nửa nên có nhiều nhất \(O(\log K)\) lần. Tổng độ dài chuỗi ở mỗi độ sâu không vượt độ dài ban đầu. Công việc mỗi tầng nhiều nhất \(O(K \log K)\) để chạy Dijkstra từ 4 dấu ngoặc đặc biệt. Mỗi truy vấn được xét nhiều nhất một lần ở mỗi tầng, nên tổng độ phức tạp là \(O(K \log^2 K + Q \log K)\).
Một số vấn đề thường gặp
Các vấn đề sau có thể giải thích kết quả Wrong Answer hoặc Time Limit Exceeded:
- Các cạnh là có hướng! Khoảng cách từ A tới B không nhất thiết bằng từ B tới A. Với lời giải dự kiến, ta phải chạy Dijkstra hai lần, không chỉ một lần.
- Giá trị biểu diễn "vô cực" phải đủ lớn nhưng không được lớn tới mức gây tràn số.
- Chọn ngẫu nhiên một cạnh rồi chỉ chia thành trong và ngoài nhìn chung quá chậm. Ngay cả khi tách trái và phải nếu chúng không liên thông, vẫn có thể gặp vấn đề. Gọi \(X =\)
((((( ... )))))có độ dài \(\sqrt{N}\). Nếu dữ liệu vào làXXXXX ... XXXX, gồm \(\sqrt{N}\) bản sao của \(X\), chọn ngẫu nhiên không hiệu quả. Để thực sự giảm kích thước dữ liệu, ta phải may mắn chọn trúng một điểm ngoài cùng của \(X\).
Nguồn
Dựa trên phân tích chính thức của Google Code Jam 2020, Round 2 — Emacs++.
Bình luận