Hướng dẫn cho Google Code Jam 2020 - Musical Cords
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Test Set 1
Ta được cho một đường tròn, các điểm trên chu vi và giá trị gắn của mỗi điểm (\(L_i\)). Ta muốn tìm \(K\) cặp làm lớn nhất tổng khoảng cách Euclid và các giá trị gắn. Trong Test Set 1, các giá trị được chọn ngẫu nhiên và ta cần tận dụng điều đó. Vì \(K=1\), ta chỉ tìm cặp tốt nhất.
Xét các điểm quanh đường tròn theo chiều kim đồng hồ. Giả sử đang ở \(p\). Không mất tính tổng quát, chỉ xét các điểm cách \(p\) nhiều nhất \(180\) độ theo chiều kim đồng hồ, tức nửa đường tròn bắt đầu tại \(p\). Nếu tìm cặp tốt nhất cho mọi \(p\), giá trị lớn nhất trong chúng là đáp án, vì cách xét này bao phủ mọi cặp ít nhất một lần.
Với mỗi \(p\), xét các điểm ghép theo chiều ngược kim đồng hồ, bắt đầu từ vị trí cách \(p\) đúng \(180\) độ theo chiều kim đồng hồ (phía bên kia đường tròn). Sau khi đã xét \(x\), một điểm \(y\) xa hơn theo chiều ngược kim đồng hồ sẽ gần \(p\) hơn. Để \(y\) tạo ra cặp tốt nhất, giá trị gắn của nó phải lớn hơn của \(x\). Vì vậy, chỉ cần xét những điểm làm giá trị gắn tăng lên.
Trong dãy \(N\) số nguyên được chọn ngẫu nhiên đều, ta kỳ vọng cực đại tiền tố chỉ đổi \(\log N\) lần: phần tử thứ nhất có xác suất \(1/1\) là cực đại mới, phần tử thứ hai là \(1/2\), thứ ba là \(1/3\), v.v. Đây là chuỗi điều hòa; tổng \(N\) số hạng đầu bị chặn bởi \(O(\log N)\). Do đó có kỳ vọng \(O(\log N)\) lần đổi cực đại và độ phức tạp thời gian kỳ vọng là \(O(N\log N)\), đủ nhanh. Trường hợp xấu nhất là \(O(N^2)\), nhưng cực kỳ khó xảy ra với giá trị gắn ngẫu nhiên.
Khi xét \(x\), ta cần tìm hiệu quả điểm đầu tiên theo chiều ngược kim đồng hồ có giá trị gắn lớn hơn \(x\). Đây là bài toán phần tử lớn hơn kế tiếp. Vì dữ liệu nằm trên đường tròn và có vòng lại, ta có thể nối mảng giá trị gắn với một bản sao của nó, rồi áp dụng thuật toán nhanh cho phần tử lớn hơn kế tiếp.
Cũng có các cách khác tốn \(O(N^2)\) trong trường hợp xấu nhất vì có thể so sánh phần lớn mọi cặp, nhưng dùng mẹo tăng tốc như nhảy tới giá trị lớn hơn kế tiếp để có khả năng cao giảm mạnh số phép so sánh.
Test Set 2
Ở test set này, các giá trị gắn không được sinh ngẫu nhiên, nên cần cách khác. Hơn nữa \(K=10\), nên phải tìm nhiều cặp. Thay vì tìm trực tiếp top \(K\), ta tìm cặp tốt nhất cho từng điểm rồi mở rộng để tìm top \(K\) toàn cục.
Với mỗi điểm đầu vào \(P\), tìm điểm đầu vào \(Q\) khác làm cực đại \(L_P+L_Q+\operatorname{distance}(P,Q)\).
Bây giờ xét cả \(P\) không nhất thiết thuộc dữ liệu vào. Định nghĩa
Nếu \(P\) là điểm đầu vào, \(V_P(Q)+L_P\) là lượng dây cần để nối \(P,Q\).
Hãy hình dung di chuyển \(P\) quanh đường tròn theo chiều kim đồng hồ và tính \(V_P(Q)\) cho mọi điểm đầu vào \(Q\) cách \(P\) nhiều nhất \(180\) độ theo chiều kim đồng hồ. Ta cần biết hàm khoảng cách tới một điểm thay đổi ra sao khi \(P\) di chuyển.
Khoảng cách Euclid là độ dài dây cung:
Góc được tính theo chiều kim đồng hồ và luôn không quá \(180\) độ. Xét \(W_Q(P)=V_P(Q)\). Vì miền của \(V_P\) là các \(Q\) trong phạm vi \(180\) độ theo chiều kim đồng hồ từ \(P\), miền của \(W_Q\) là các \(P\) trong phạm vi \(180\) độ ngược kim đồng hồ từ \(Q\).
Mỗi \(W_Q\) gồm hằng số \(L_Q\) và một hạng có dạng nửa sóng sin. Mọi đồ thị có cùng hình dạng nhưng được tịnh tiến: \(\operatorname{angle}(P,Q)\) tịnh tiến ngang và \(L_Q\) tịnh tiến dọc. Mỗi đường cong đen trong hình sau ứng với \(W_Q\) của một \(Q\) khác nhau.
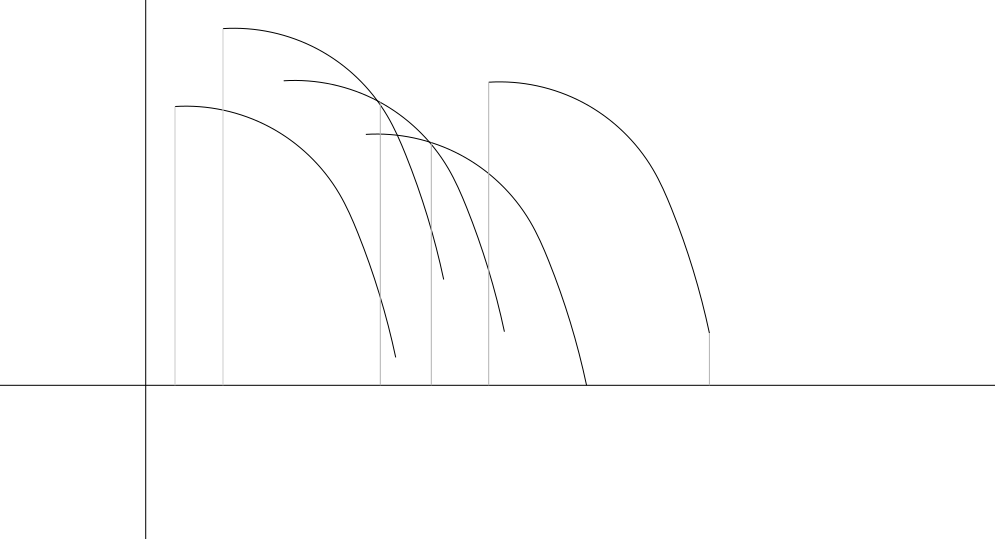
Do các hàm khoảng cách cùng hình dạng, mỗi \(W_Q\) lớn nhất so với mọi hàm khác trên một khoảng liên tục các \(P\). Nếu tính hiệu quả các khoảng này, ta tìm được cực đại ở mỗi điểm bằng cách xác định nó thuộc khoảng cực đại nào.
Quét đồ thị từ trái sang phải, tức theo chiều tăng trục hoành. Vì trục hoành biểu diễn đường tròn, hãy biểu diễn điểm bằng góc so với nửa dương trục hoành. Với góc \(A\), chỉ xét các đường cong có miền chứa ít nhất một điểm trong \([0,A]\), gọi tập đó là \(C_A\). Khi tăng \(A\), một đường cong có miền \([A,B]\) được xét lần đầu. Tại \(B\), nó chắc chắn lớn nhất trong \(C_A\) vì là đường cong duy nhất ở đó. Vậy khoảng cực đại của nó kết thúc tại \(B\); vì chỉ có một khoảng như vậy, có thể tìm kiếm nhị phân điểm bắt đầu.
Duy trì danh sách đã sắp xếp các khoảng không giao nhau và thêm khoảng mới ở cuối. Ta có thể loại các khoảng cuối bị khoảng mới phủ hoàn toàn, hoặc rút ngắn khoảng bị phủ một phần. Có thể có không hoặc nhiều khoảng trái nhất nơi đường cong mới hoàn toàn dưới đường cực đại, không hoặc nhiều khoảng phải nhất nơi nó hoàn toàn trên đường cực đại, và không hoặc đúng một khoảng nơi hai đường cắt nhau. Ta tìm kiếm nhị phân trong khoảng đó để tìm chính xác giao điểm.
Đồ thị có tính tuần hoàn vì biểu diễn khoảng cách khi đi quanh đường tròn, nên các hàm có thể vòng qua điểm kết thúc. Tương tự Test Set 1, nối dữ liệu với một bản sao của chính nó và duyệt hai vòng.
Danh sách khoảng cuối cho cặp tốt nhất của từng điểm: với mỗi điểm đầu vào \(P\), tìm \(Q\) có \(W_Q\) lớn nhất tại \(P\). Vì chỉ kiểm tra các \(P\) đầu vào, có thể giới hạn miền của mọi hàm và khoảng vào các điểm đầu vào mà không mất tính đúng đắn. Nhờ vậy, ta tìm kiếm nhị phân trên mảng \(O(N)\) giá trị thay vì một khoảng số thực.
Xây dựng danh sách khoảng tốn \(O(N\log N)\). Sau đó, với mỗi \(Q\), duyệt các \(P\) khả dĩ trong khoảng của nó. Một \(Q\) có thể có khoảng dài, nhưng tổng thể mỗi \(P\) chỉ được duyệt nhiều nhất một lần (hoặc hai lần vì nhân đôi dữ liệu), nên bước cuối là tuyến tính.
Có tồn tại thuật toán \(O(N)\) cho bài toán trên; phần này được để lại như bài tập cho người đọc.
Cuối cùng, cần tìm \(K\) cặp không thứ tự tốt nhất. Một cặp trong top \(K\) có thể không nằm trong danh sách cặp tốt nhất của từng điểm, nhưng danh sách vẫn hữu ích. Sắp xếp nó giảm dần theo tổng khoảng cách Euclid và giá trị gắn. Phần tử đầu chắc chắn là cặp tốt nhất toàn cục. Cặp tốt thứ hai hoặc là phần tử tiếp theo trong danh sách, hoặc chứa một điểm của cặp tốt nhất; xét mọi cặp chứa hai điểm ấy sẽ xác định được nó. Lặp lại để tìm top \(K\): mỗi bước chọn cặp tốt nhất tiếp theo chưa xét trong danh sách, hoặc một cặp chứa điểm đã xuất hiện trong các cặp trước. Mỗi bước tốn \(O(N)\); sắp xếp ban đầu tốn \(O(N\log N)\). Tổng độ phức tạp là \(O(N\log N+N\times K)\), đủ nhanh.
Nguồn
Phần phân tích này được dịch đầy đủ từ lời giải chính thức của Google Code Jam 2020, Chung kết thế giới trực tuyến — Musical Cords.
Bình luận