Hướng dẫn cho Google Code Jam 2014 - Full Binary Tree
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích: Full Binary Tree
Thuật toán vét cạn:
Cho một cây có \(N\) nút, có \(2^N\) tập con các nút có thể bị xóa khỏi cây. Thuật toán vét cạn đơn giản là kiểm tra tất cả các cách xóa nút có thể và chọn cách mà các nút còn lại tạo thành một cây nhị phân đầy đủ và số lượng nút bị xóa là tối thiểu. Lưu ý rằng khi một tập hợp các nút bị xóa khỏi cây, các nút còn lại có thể không còn là một cây nữa (vì cây có thể bị mất liên thông).
Giả sử có \(M\) nút còn lại sau khi xóa. Một cách để kiểm tra xem các nút còn lại có tạo thành một cây nhị phân đầy đủ hay không là trước tiên kiểm tra xem nó có còn là một cây hay không. Điều này có thể được thực hiện bằng cách thực hiện tìm kiếm theo chiều rộng (BFS) hoặc tìm kiếm theo chiều sâu (DFS) đơn giản để kiểm tra xem các nút còn lại có nằm trong một thành phần liên thông duy nhất hay không. Tiếp theo, chúng ta cần tìm một gốc trong cây đó sao cho tất cả các cây con của nó có 0 hoặc 2 con. Điều này dẫn đến một thuật toán \(O(M^2)\) để kiểm tra xem các nút còn lại có tạo thành một cây nhị phân đầy đủ hay không.
Một cách khác để kiểm tra xem một đồ thị có phải là cây nhị phân đầy đủ hay không là thông qua việc đếm với độ phức tạp tuyến tính \(O(M)\):
- Đối với trường hợp tầm thường khi \(M\) bằng 1, đó là một cây nhị phân đầy đủ.
- Đối với \(M > 1\), nó phải thỏa mãn điều kiện có đúng một nút có bậc bằng 2 và các nút còn lại phải có bậc bằng 1 hoặc 3. Ngoài ra, số lượng cạnh còn lại phải bằng \(M - 1\) để biểu thị rằng đó là một cây, chứ không phải một đồ thị rời rạc.
Do đó, sử dụng các phương pháp khác nhau để kiểm tra xem đồ thị kết quả có phải là cây nhị phân đầy đủ hay không, bạn sẽ có một thuật toán vét cạn chạy trong \(O(2^N \cdot N^2)\) hoặc \(O(2^N \cdot N)\), đủ để giải quyết Small dataset. Nhưng nó không đủ để giải quyết Large dataset nơi \(N = 1000\). Trong các phần sau, chúng ta sẽ giải quyết Large dataset.
Thuật toán bậc hai:
Cốt lõi của thuật toán bậc hai là việc giảm thiểu số lượng nút bị xóa tương đương với việc tối đa hóa số lượng nút không bị xóa.
Hãy chọn một gốc cho cây ban đầu. Mối quan hệ cha-con được xác định dựa trên gốc đã chọn. Đối với mỗi nút, chúng ta sẽ đưa ra quyết định xóa nó hoặc giữ lại nó với mục tiêu tối đa hóa kích thước của cây con nhị phân đầy đủ. Bây giờ chúng ta xem xét các trường hợp khác nhau cho mỗi nút. Nếu một nút chỉ có một con, thì chúng ta phải loại bỏ con đó (vì nó vi phạm điều kiện cây nhị phân đầy đủ là có 0 hoặc 2 con). Do đó, kích thước của cây con đó chỉ là một nút (tức là chúng ta chỉ đếm chính nút đó). Nếu nó có nhiều hơn một nút con tiềm năng, chúng ta phải chọn hai trong số chúng làm con của nút đó. Nhưng chọn hai nút nào? Chúng ta chọn hai nút mà giữ lại được số lượng nút tối đa trong cây con của chính chúng, điều mà chúng ta sẽ minh họa sau đây.
Chúng ta có thể thực hiện ý tưởng trên thông qua một chuyến duyệt DFS hậu thứ tự (post-order) tham lam từ một gốc đã chọn. Trong quá trình duyệt, chúng ta xác định số lượng nút tối đa có thể giữ lại trong mỗi cây con để tạo thành một cây nhị phân đầy đủ. Hàm maxSubtreeNodes(node, parent) như sau:
- Các tham số của hàm là nút hiện tại và cha của nó.
- Nếu nút hiện tại có 0 hoặc 1 con (trong số các nút kề không phải cha), thì số lượng nút trong cây con này là 1.
- Nếu không, chúng ta có ít nhất hai cây con và chúng ta nên gọi đệ quy hàm cho mỗi nút con của nút hiện tại. Hãy nhớ rằng, chúng ta muốn tối đa hóa số lượng nút được giữ lại trong cây con của nút hiện tại, do đó chúng ta giữ lại hai nút con có cây con lớn nhất bắt nguồn từ các nút con đó. Chúng ta trả về tổng kích thước của hai cây con lớn nhất đó + 1 (1 để tính nút hiện tại).
Cuối cùng, với hàm này, số lượng nút tối thiểu cần xóa cho một nút gốc nhất định là:
N - maxSubtreeNodes(root, 0) // 0 as the root does not have a parent.
Chúng ta có thể chạy hàm maxSubtreeNodes(root, 0) bằng cách chọn mỗi nút trong số \(N\) nút làm gốc. Chúng ta chọn nút gốc làm cực tiểu hóa giá trị \(N - maxSubtreeNodes(root, 0)\). Vì maxSubtreeNodes(root, 0) là một chuyến duyệt DFS trên cây, nó chạy trong thời gian \(O(N)\). Ngoài ra, chúng ta chạy chuyến duyệt \(N\) lần, mỗi lần chọn một nút làm gốc. Do đó, độ phức tạp thời gian là \(O(N^2)\).
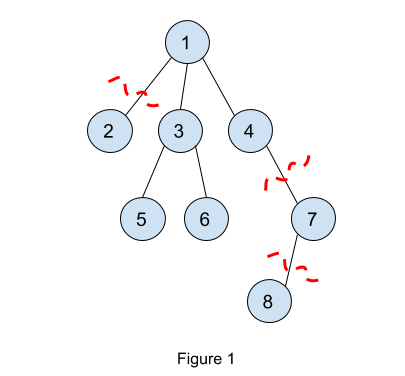
Hình 1 cho thấy một ví dụ minh họa việc chạy maxSubtreeNodes(1, 0). Nút 8 bị xóa vì nó là con duy nhất của nút 7. Sau đó nút 7 bị xóa vì lý do tương tự. Sau đó, nút 1 sẽ phải chọn chỉ hai con trong số các nút 2, 3 và 4. Ba cây con này có kích thước lần lượt là 1, 3 và 1. Vì vậy, nút 1 sẽ chọn hai cây con lớn nhất là các nút 3 và 4 (lưu ý chúng ta cũng có thể chọn nút 2 thay vì nút 4). Vì vậy, đối với maxSubtreeNodes(1, 0), số lượng nút tối đa có thể giữ lại là 5 (các nút 1, 3, 4, 5 và 6). Tương đương, số lượng nút tối thiểu cần xóa là 3 (các nút 2, 7 và 8).
Dưới đây là mã giả cho thuật toán này:
minDeletions = infinity
for root = 1 to N:
  minDeletions = min(minDeletions, N - maxSubtreeNodes(root, 0))

def maxSubtreeNodes(currentNode, parent):
  maximumTwoNumbers = {}  // Structure that keeps track of
  // the maximum two numbers.
  for x in neighbors of currentNode:
     if x == parent:
       continue
     update maximumTwoNumbers with maxSubtreeNodes(x, currentNode)
  if size of maximumTwoNumbers == 2:
    return 1 + sum(maximumTwoNumbers)
  return 1
Thuật toán tuyến tính:
Thuật toán bậc hai ở trên đủ để giải quyết Large dataset nhưng bạn có thể quan tâm đến một giải pháp có độ phức tạp thời gian tốt hơn. Chúng tôi trình bày ở đây một thuật toán thời gian tuyến tính dựa trên thuật toán thời gian bậc hai.
Trong thuật toán bậc hai, chúng ta mất \(O(N)\) để tính toán kích thước của hai cây con lớn nhất cho bất kỳ nút gốc nào (hãy nhớ rằng, chúng ta duyệt qua tất cả \(N\) nút gốc có thể). Vì vậy, mục tiêu của chúng ta trong thuật toán thời gian tuyến tính là tính toán kích thước của hai cây con lớn nhất cho bất kỳ nút nào trong thời gian hằng số. Để làm như vậy, chúng ta sẽ tính toán trước ba cây con lớn nhất của các con (không chỉ hai như trong thuật toán bậc hai). Chúng tôi sẽ giải thích lý do tại sao chúng ta cần ba cây con lớn nhất trong đoạn tiếp theo.
Vì vậy, hãy xác định cấu trúc bảng tính toán trước của chúng ta. Nó là một mảng một chiều gồm các đối tượng được gọi là top3, được định nghĩa như sau:
  class top3:
    class pair:
      int size
      int subtreeRoot
    pair children[3]  // children is sorted by the size value.
    int parent
Trong hàm DFS tham lam maxSubtreeNodes(node, parent), chỉ có \(2 \cdot (N-1)\) cặp tham số khác nhau cho hàm (một cặp tham số là cặp nút, cha, và cũng có đúng \(N-1\) cạnh trong bất kỳ cây nào). Chìa khóa cho thuật toán tuyến tính của chúng ta là chạy DFS một lần trên cây đã cho từ một nút gốc nào đó (giả sử từ nút 1), và trong chuyến duyệt này đối với mọi nút, lưu trữ ba cây con lớn nhất trong số các con của nó đồng thời theo dõi nút cha của nút đó. Chúng tôi sẽ giải thích sau tại sao chúng ta cần theo dõi nút cha. Chuyến duyệt DFS này sẽ là \(O(N)\) vì nó thăm mỗi nút đúng một lần.
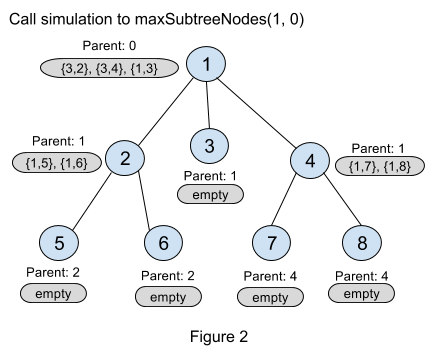
Hình 2 là hình minh họa cho các đối tượng top3 được lưu trữ cho mọi nút sau khi gọi maxSubtreeNodes(1, 0). Đối với nút 2, {1, 5} có nghĩa là cây con bắt nguồn từ nút con 5 có kích thước tối đa là 1, và "Parent: 1" có nghĩa là cha của nút 2 là 1.
Nhưng sau khi thực hiện tính toán trước này, vẫn còn thiếu một thứ trong tính toán của chúng ta. Chúng ta đã giả định rằng nút 1 là gốc nhưng trong thuật toán bậc hai ban đầu, chúng ta cần thử tất cả các nút làm gốc. Bây giờ chúng tôi chỉ ra cách chúng ta có thể tránh việc phải thử tất cả các nút làm gốc. Trong hàm được mô tả ở trên, đối với bất kỳ nút nào, cha của nó không được coi là một ứng cử viên để đưa vào mảng top3 con của nút đó. Bây giờ chúng tôi mô tả một ví dụ để chỉ ra cách chúng ta tính đến nút cha của một nút cụ thể. Trong ví dụ này, chúng ta sẽ sử dụng thông tin của nút cha để cập nhật mảng top3 cho nút hiện tại.
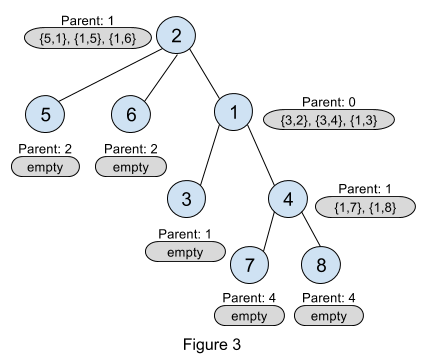
Chúng tôi mô tả một quá trình cập nhật cục bộ để sửa mảng top3 cho nút 2. Hãy nhớ rằng cha của nút 2 là nút 1 (xem Hình 2). Hãy giả vờ rằng nút 2 được chọn làm gốc (như trong Hình 3). Sau đó, chúng ta nhìn vào mảng top3 của cha nó (nút 1). Lưu ý rằng phần tử hàng đầu trong mảng top3 cho nút 1 thực tế là nút 2! Chúng ta cập nhật mảng top3 của nút 2 bằng mảng top3 của nút 1, do đó chúng ta loại trừ kết quả cho nút 2 khỏi mảng top3 của nút 1. Sau khi loại trừ nút 2 khỏi mảng top3 của nút 1, cặp kết quả mô tả nút 1 là {5, 1} (tức là kích thước của cây con bắt nguồn từ nút 1 ngoại trừ nút 2 là 5: các nút 1, 3, 4, 7 và 8). Bây giờ chúng ta cập nhật mảng top3 cho nút 2 với {5, 1}. Do đó, bây giờ mảng top3 của nút 2 là: {5, 1}, {1, 5}, {1, 6}, và kích thước của cây nhị phân đầy đủ lớn nhất bắt nguồn từ nút 2 là 7 (5 + 1 từ hai con đầu tiên, và 1 để tính chính nút 2).
Chúng ta thực hiện quá trình cập nhật cục bộ được mô tả trong đoạn trước trong một chuyến duyệt DFS tiền thứ tự (pre-order) bắt đầu từ nút 1. Lưu ý rằng khi thực hiện cập nhật cục bộ, việc loại trừ nút hiện tại khỏi mảng top3 của cha nó có thể dẫn đến một mảng chỉ có một phần tử. Trong những trường hợp như vậy, cây con của cha (ngoại trừ nút hiện tại) phải có kích thước là 1.
Có thể bạn vẫn đang thắc mắc tại sao chúng ta cần ba cây con lớn nhất mà không phải hai. Quan sát trong Hình 3, nếu chúng ta chỉ lưu trữ top 2 thay vì top 3 cây con ở nút 1 (nghĩa là chỉ {3, 2} và {3, 4}) và chúng ta loại trừ nút 2 trong quá trình cập nhật cục bộ, thì chúng ta sẽ chỉ có cặp {3, 4} mô tả nút 4 nhưng bỏ qua nút 3! Điều này sẽ không chính xác vì nút 3 là một phần của cây nhị phân đầy đủ bắt nguồn từ nút 1. Do đó, chúng ta giữ thông tin cho ba cây con lớn nhất.
Dựa trên phân tích chính thức của Google Code Jam.
Bình luận