Hướng dẫn cho Google Code Jam 2014 - ARAM
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích
Chúng ta sẽ sử dụng tìm kiếm nhị phân để tìm đáp án. Tại mỗi lần lặp của tìm kiếm nhị phân, chúng ta có một ước lượng cho đáp án \(Q\), và chúng ta cần quyết định xem ước lượng đó quá cao hay quá thấp. Chúng ta thực hiện việc này bằng cách cố gắng tìm một chiến thuật có thể đạt được tỉ lệ thắng \(Q\) trong dài hạn.
Chúng ta cần mô tả một chiến thuật hợp lệ là gì. Trong một công thức quy hoạch động đơn giản cho bài toán này, trạng thái hiện tại sẽ là tướng chúng ta được chỉ định, số tiền chúng ta có và số trận đấu còn lại; quyết định tại mỗi trạng thái là có nên đổ lại (reroll) hay không.
Rõ ràng chúng ta không thể tính toán quyết định cho từng trạng thái này một cách riêng lẻ; có \(O(10^{100} \cdot N \cdot R \cdot G)\) trạng thái! Nhưng vì số lượng trận đấu sẽ chơi là cực lớn, chúng ta có thể giả định rằng số trận đấu còn lại là không quan trọng, và chỉ cần tối ưu hóa giả định rằng còn "vô hạn" trận đấu phía trước. Có thể chứng minh rằng sai số mà giả định này gây ra cho đáp án nhỏ hơn nhiều so với \(10^{-10}\), độ chính xác yêu cầu. Cũng lưu ý rằng nếu chúng ta đổ lại khi được chỉ định một tướng nào đó với một số tiền cụ thể, thì việc đổ lại khi được chỉ định một tướng có xác suất thắng thấp hơn với cùng số tiền đó cũng là hợp lý. Vì vậy, để tính toán một chiến thuật, chúng ta chỉ cần quyết định với mỗi mức tiền, tướng nào có xác suất thắng cao nhất mà chúng ta vẫn sẽ đổ lại.
Nhưng làm thế nào để đánh giá một chiến thuật tốt như thế nào khi chúng ta sẽ chơi vô hạn trận? Khi chúng ta ít tiền, chúng ta cần thận trọng hơn về việc khi nào nên đổ lại. Nếu chúng ta đổ lại quá hăng hái khi còn rất ít tiền và số tiền giảm xuống dưới 1 đô la, chúng ta sẽ không thể đổ lại trong một thời gian và số trận thắng kỳ vọng sẽ giảm xuống. Trực giác là chúng ta cần xác định, nếu tiền của chúng ta xuống thấp, giả sử còn \(M\) đô la, thì chúng ta sẽ bị tụt lại bao nhiêu so với số trận thắng kỳ vọng trước khi số tiền của chúng ta tăng lên \(M + 1/G\)?
Chúng ta định nghĩa "thặng dư" (surplus) cho một tập hợp các trận đấu là số trận thắng trong tập hợp đó trừ đi \(Q\) nhân với số trận đấu đã chơi. Chúng ta chọn chiến thuật tại mức tiền \(M\) để tối đa hóa thặng dư kỳ vọng của tập hợp các trận đấu xảy ra cho đến khi chúng ta đạt được \(M + 1/G\) tiền. (Nếu \(M\) bằng \(R\), thì số tiền của chúng ta sẽ không tăng thêm, vì vậy chúng ta sử dụng tập hợp các trận đấu kéo dài cho đến khi chúng ta lại có \(M\) tiền.) Gọi giá trị này là \(A[M]\).
Nếu \(M < 1\), chúng ta không thể đổ lại, vì vậy:
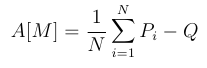
vì tập hợp sẽ bao gồm đúng một trận đấu, và chúng ta nhận một tướng ngẫu nhiên.
Với \(1 \le M < R\), giả sử chiến thuật của chúng ta yêu cầu đổ lại \(K_M\) tướng tệ nhất. Sắp xếp các giá trị \(P_i\). Khi đó:
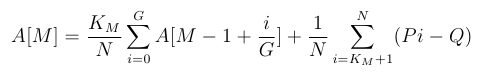
Tương tự, với \(M = R\):
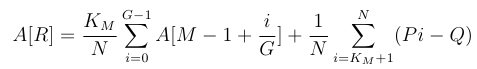
Chúng ta có thể tính toán các giá trị tối ưu cho \(A\) bằng cách tối ưu hóa cho \(K_M\) riêng biệt cho mỗi \(M\) từ 0 đến \(R\). Lưu ý rằng \(A[M] \ge -1\) với mọi \(M\), vì chiến thuật không bao giờ đổ lại có thặng dư không tệ hơn \(-1\), vì vậy chiến thuật tối ưu phải ít nhất là tốt như thế.
Nếu \(A[R] \ge 0\), chúng ta quyết định rằng \(Q\) quá thấp (hoặc vừa đủ). Nếu \(A[R] < 0\), chúng ta quyết định rằng \(Q\) quá cao. Bây giờ chúng ta chứng minh điều này hoạt động.
Chúng ta bắt đầu với \(R\) tiền. Chúng ta sẽ quay lại mức \(R\) tiền nhiều lần, với thặng dư kỳ vọng \(A[R]\) mỗi lần, cho đến khi cuối cùng đạt đến \(10^{100}\) trận đấu và dừng lại. Thay vào đó, hãy xem xét kịch bản mà khi đạt đến \(10^{100}\) trận đấu, chúng ta tiếp tục chơi cho đến khi đạt lại mức \(R\) tiền. Thặng dư kỳ vọng trong kịch bản này là \(T \cdot A[R]\), trong đó \(T \ge 1\) là số lần kỳ vọng chúng ta quay lại mức \(R\) tiền. Bây giờ, gọi \(X\) là thặng dư kỳ vọng của các trận đấu sau trận thứ \(10^{100}\). Từ định nghĩa của \(A\), \(X = A[M] + A[M+1/G] + \dots + A[R-1/G]\), trong đó \(M\) là số tiền chúng ta có sau trận đấu thứ \(10^{100}\).
Giả sử \(A[M] < 0\) với \(M < R\) (nếu không, chúng ta có thể chơi như thể \(R\) bằng với mức \(M\) thấp nhất sao cho \(A[M] \ge 0\) và chứng minh vẫn đúng). Khi đó \(-RG \le X < 0\).
Bây giờ thặng dư cho \(10^{100}\) trận đầu tiên là \(Y = T \cdot A[R] - X\). Do đó \(T \cdot A[R] < Y \le T \cdot A[R] + RG\).
\(RG\) là không đáng kể so với \(10^{100}\) trận đấu. Vì vậy, tỉ lệ thắng kỳ vọng cho chiến thuật này là \(Q + T \cdot A[R] \cdot 10^{-100}\). Vì vậy, chúng ta khẳng định rằng nếu \(A[R] \ge 0\), chúng ta có thể đạt được một chiến thuật thắng với tỉ lệ ít nhất là \(Q\), và ngược lại thì không. Điều này cho phép tìm kiếm nhị phân hội tụ đến một câu trả lời đủ chính xác.
Dưới đây là một ví dụ cài đặt bằng Python 3. Để tránh số tiền lẻ, chúng ta giới thiệu một đơn vị nhỏ hơn (ví dụ: một đồng xu) \(C\) cho tiền tệ sao cho \(G\) đồng xu bằng một đô la.
# Can you win at least X fraction of the time?
def CanWin(X):
  A = []
  last_G_values = 0

  # C < G, not enough coins for a reroll.
  for C in range(0, G):
    A.append(avg_win_prob_top[N] - X)
    last_G_values += A[C]

  # C >= G, enough coins for a reroll.
  for C in range(G, R * G + 1):
    A.append(-1e100)
    for K in range(1, N + 1):
      p = (N - K) / N  # Probability of rerolling.
      p_reroll = p / (1 - p) * last_G_values
      p_not_reroll = avg_win_prob_top[K] - X
      A[C] = max(A[C], p_reroll + p_not_reroll)

    if A[C] >= 0: return True
    last_G_values += A[C] - A[C - G]

  return False


for tc in range(int(input())):
  [N, R, G] = map(int, input().split())
  win_prob = map(float, input().split())
  win_prob = sorted(win_prob, reverse=True)

  avg_win_prob_top = [0]
  for topK in range(1, N + 1):
    avg_win_prob_top.append(sum(win_prob[0:topK]) / topK)

  lo = 0
  hi = 1
  for i in range(60):
    mid = (lo + hi) / 2
    if CanWin(mid):
      lo = mid
    else:
      hi = mid

  print("Case #%d: %.15f" % (tc + 1, lo))
Một giải pháp thay thế là đánh giá các chiến thuật bằng cách mô hình hóa trò chơi dưới dạng một chuỗi Markov và tính toán phân phối dừng của nó, sau đó cải thiện chiến thuật một cách lặp đi lặp lại. Tuy nhiên, khá khó để thực hiện việc này với độ chính xác cần thiết.
Dựa trên phân tích chính thức của Google Code Jam.
Bình luận