IOI 2025 — Migrations
Xem PDFBảo tàng Lịch sử Tự nhiên đang nghiên cứu các kiểu di cư của khủng long ở Bolivia. Các nhà cổ sinh vật học đã phát hiện ra dấu chân khủng long tại \(N\) địa điểm khác nhau, được đánh số từ \(0\) đến \(N-1\) theo thứ tự tuổi giảm dần: địa điểm \(0\) chứa các dấu chân cổ nhất, còn địa điểm \(N-1\) chứa các dấu chân trẻ nhất.
Khủng long đã di cư đến mỗi địa điểm (trừ địa điểm \(0\)) từ một địa điểm cổ hơn nào đó. Với mọi địa điểm \(i\) thỏa mãn \(1 \le i \le N-1\), tồn tại đúng một địa điểm cổ hơn \(P[i]\) (với \(P[i] < i\)) sao cho có một số khủng long đã di cư trực tiếp từ địa điểm \(P[i]\) sang địa điểm \(i\). Một địa điểm cổ có thể là nguồn di cư đến nhiều địa điểm trẻ hơn.
Các nhà cổ sinh vật học mô hình hóa mỗi cuộc di cư như là một cạnh vô hướng giữa địa điểm \(i\) và \(P[i]\). Lưu ý rằng với hai địa điểm phân biệt \(x\) và \(y\) bất kỳ, ta luôn có thể đi từ \(x\) đến \(y\) bằng cách đi qua một dãy các cạnh. Khoảng cách giữa hai địa điểm \(x\) và \(y\) được định nghĩa là số cạnh ít nhất cần đi để đi từ \(x\) đến \(y\).
Ví dụ, với \(N = 5\) và \(P[1] = 0\), \(P[2] = 1\), \(P[3] = 2\), \(P[4] = 2\), ta có thể đi từ địa điểm \(3\) đến địa điểm \(4\) qua \(2\) cạnh, vậy khoảng cách giữa chúng là \(2\).
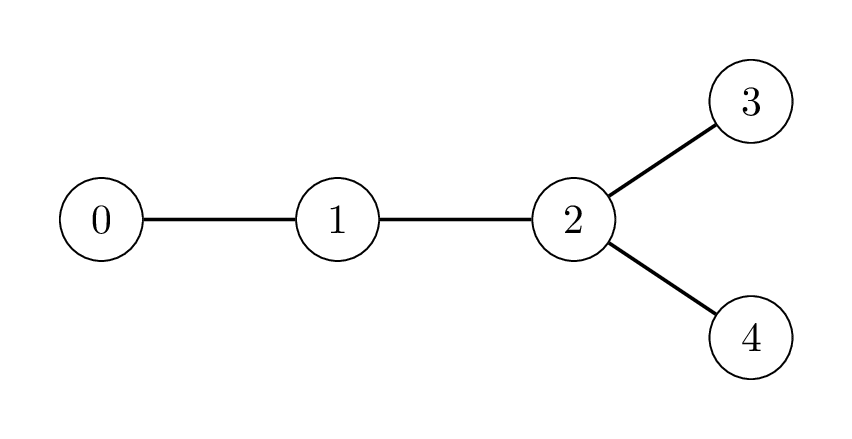
Bảo tàng muốn xác định một cặp địa điểm có khoảng cách lớn nhất có thể (tức là đường kính của cây). Lưu ý rằng cặp này không nhất thiết duy nhất: chẳng hạn trong ví dụ trên, cả hai cặp \((0, 3)\) và \((0, 4)\) đều có khoảng cách \(3\) là lớn nhất. Trong các trường hợp như vậy, bất kỳ cặp nào đạt khoảng cách lớn nhất đều được xem là hợp lệ.
Ban đầu, các giá trị \(P[i]\) chưa được biết. Bảo tàng cử một nhóm nghiên cứu lần lượt đến thăm các địa điểm \(1, 2, \ldots, N-1\). Khi đến địa điểm \(i\) (\(1 \le i \le N-1\)), nhóm nghiên cứu thực hiện cả hai hành động sau:
- Xác định giá trị \(P[i]\), tức là nguồn của cuộc di cư đến địa điểm \(i\).
- Quyết định gửi đúng một thông điệp về Bảo tàng hoặc không gửi thông điệp nào từ địa điểm này, dựa trên thông tin đã thu thập được trước đó.
Các thông điệp được truyền qua một hệ thống vệ tinh đắt tiền, nên mỗi thông điệp phải là một số nguyên trong khoảng từ \(1\) đến \(20\,000\). Ngoài ra, nhóm nghiên cứu chỉ được phép gửi tối đa \(50\) thông điệp trong toàn bộ quá trình.
Nhiệm vụ của bạn là cài đặt một chiến lược, qua đó:
- Nhóm nghiên cứu chọn các địa điểm để gửi thông điệp, cùng với giá trị của mỗi thông điệp.
- Bảo tàng có thể xác định một cặp địa điểm có khoảng cách lớn nhất, chỉ dựa trên các thông điệp nhận được từ mỗi địa điểm và biết các thông điệp được gửi từ địa điểm nào.
Việc gửi số lớn qua vệ tinh tốn chi phí cao. Điểm số của bạn sẽ phụ thuộc vào cả số nguyên lớn nhất được gửi và tổng số thông điệp được truyền đi.
Chi tiết cài đặt
Đây là một bài toán giao tiếp gồm hai pha. Chương trình của bạn sẽ được chạy đúng hai lần, và không có dữ liệu nào được lưu giữa hai lần chạy (các biến toàn cục, file, v.v., đều bị xóa). Hai pha chỉ liên lạc với nhau qua mảng \(S\).
Bạn cần cài đặt hai hàm sau trong file migrations.h:
Pha 1 (mã hóa) — dành cho nhóm nghiên cứu:
int send_message(int N, int i, int Pi)
- \(N\): số địa điểm có dấu chân.
- \(i\): chỉ số của địa điểm nhóm nghiên cứu đang đến thăm.
- \(Pi\): giá trị \(P[i]\).
- Hàm này được gọi \(N-1\) lần với mỗi test, theo thứ tự \(i = 1, 2, \ldots, N-1\).
Hàm này phải trả về \(S[i]\) chỉ định hành động của nhóm nghiên cứu tại địa điểm \(i\):
- \(S[i] = 0\): nhóm quyết định không gửi thông điệp từ địa điểm \(i\).
- \(1 \le S[i] \le 20\,000\): nhóm gửi số nguyên \(S[i]\) làm thông điệp từ địa điểm \(i\).
Pha 2 (giải mã) — dành cho Bảo tàng:
std::pair<int,int> longest_path(std::vector<int> S)
- \(S\): mảng có độ dài \(N\) sao cho:
- \(S[0] = 0\).
- Với mỗi \(1 \le i \le N-1\), \(S[i]\) là giá trị mà
send_message(N, i, Pi)đã trả về. - Hàm này được gọi đúng một lần cho mỗi test.
Hàm này phải trả về cặp địa điểm \((U, V)\) có khoảng cách lớn nhất.
Trong quá trình chấm thực tế, một chương trình gọi các hàm trên được chạy đúng hai lần.
- Trong lần chạy thứ nhất:
send_messageđược gọi đúng \(N-1\) lần.- Chương trình của bạn có thể lưu trữ và giữ lại thông tin giữa các lần gọi liên tiếp (trong cùng pha 1).
- Các giá trị trả về (mảng \(S\)) được hệ thống chấm lưu lại.
- Trong một số trường hợp, hành vi của trình chấm là thích nghi (adaptive). Điều này có nghĩa là giá trị \(P[i]\) trong một lần gọi
send_messagecó thể phụ thuộc vào các hành động của nhóm nghiên cứu trong các lần gọi trước đó. - Trong lần chạy thứ hai:
longest_pathđược gọi đúng một lần. Thông tin duy nhất màlongest_pathcó được từ lần chạy thứ nhất là mảng \(S\).
Ràng buộc
- \(N = 10\,000\)
- \(0 \le P[i] < i\) với mỗi \(i\) thỏa \(1 \le i \le N-1\).
Phân nhóm
- Subtask 1 (30 điểm): Địa điểm \(0\) và một địa điểm khác nào đó có khoảng cách lớn nhất trong tất cả các cặp địa điểm.
- Subtask 2 (70 điểm): Không có ràng buộc bổ sung.
Gọi \(Z\) là số nguyên lớn nhất xuất hiện trong mảng \(S\), và \(M\) là số thông điệp (số phần tử khác \(0\)) mà nhóm nghiên cứu đã gửi.
Trong bất kỳ test nào, nếu có ít nhất một trong các điều kiện sau xảy ra, điểm của bạn cho test đó sẽ là \(0\) (hiển thị Output isn't correct trong CMS):
- Có ít nhất một phần tử trong \(S\) không hợp lệ.
- \(Z > 20\,000\) hoặc \(M > 50\).
- Giá trị trả về của
longest_pathkhông đúng.
Ngược lại, điểm của bạn cho subtask 1 được tính như sau:
| Điều kiện | Điểm |
|---|---|
| \(9\,998 \le Z \le 20\,000\) | \(10\) |
| \(102 \le Z \le 9\,997\) | \(16\) |
| \(5 \le Z \le 101\) | \(23\) |
| \(Z \le 4\) | \(30\) |
Điểm của bạn cho subtask 2 được tính như sau:
| Điều kiện | Điểm |
|---|---|
| \(5 \le Z \le 20\,000\) và \(M \le 50\) | \(35 - 25 \log_{4000}\left(\dfrac{Z}{5}\right)\) |
| \(Z \le 4\) và \(32 \le M \le 50\) | \(40\) |
| \(Z \le 4\) và \(9 \le M \le 31\) | \(70 - 30 \log_{4}\left(\dfrac{M}{8}\right)\) |
| \(Z \le 4\) và \(M \le 8\) | \(70\) |
Ví dụ
Giả sử \(N = 10\,000\). Xét tình huống \(P[1] = 0\), \(P[2] = 1\), \(P[3] = 2\), \(P[4] = 2\), và \(P[i] = 1\) với mọi \(i > 4\).
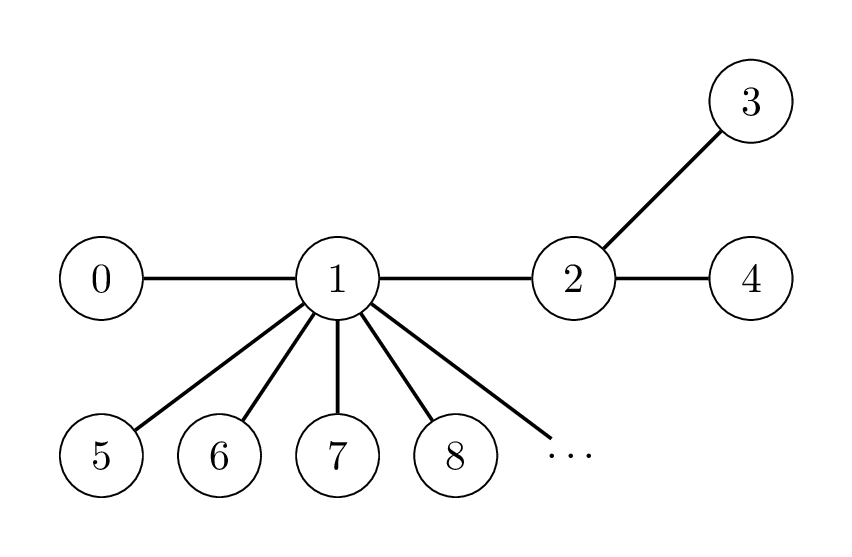
Giả sử chiến lược của nhóm nghiên cứu là: bất cứ khi nào cặp \((U, V)\) có khoảng cách lớn nhất thay đổi sau một lần gọi send_message, nhóm gửi thông điệp \(10 \cdot V + U\).
Ban đầu, cặp có khoảng cách lớn nhất là \((U, V) = (0, 0)\). Xét dãy lời gọi sau trong lần chạy thứ nhất:
| Lời gọi hàm | \((U, V)\) | Giá trị trả về \(S[i]\) |
|---|---|---|
send_message(10000, 1, 0) |
\((0, 1)\) | \(10\) |
send_message(10000, 2, 1) |
\((0, 2)\) | \(20\) |
send_message(10000, 3, 2) |
\((0, 3)\) | \(30\) |
send_message(10000, 4, 2) |
\((0, 3)\) | \(0\) |
Lưu ý rằng trong tất cả các lời gọi còn lại, \(P[i] = 1\). Điều này có nghĩa là cặp có khoảng cách lớn nhất không thay đổi, và nhóm không gửi thêm thông điệp nào nữa.
Sau đó, trong lần chạy thứ hai, lời gọi sau được thực hiện:
longest_path([0, 10, 20, 30, 0, ...])
Bảo tàng đọc thông điệp cuối cùng mà nhóm nghiên cứu đã gửi, đó là \(S[3] = 30\), và suy ra rằng \((0, 3)\) là cặp địa điểm có khoảng cách lớn nhất. Do đó, lời gọi này trả về \((0, 3)\).
Lưu ý rằng cách tiếp cận này không phải lúc nào cũng giúp Bảo tàng xác định đúng cặp có khoảng cách lớn nhất.
Sample input:
5
0 1 2 2
Sample output:
10 20 30 0
0 3
Chấm điểm
Trình chấm mẫu gọi cả send_message và longest_path trong cùng một lần chạy, khác với trình chấm thực tế.
Định dạng input:
N
P[1] P[2] ... P[N-1]
Định dạng output:
S[1] S[2] ... S[N-1]
U V
Bạn có thể sử dụng trình chấm mẫu với giá trị \(N\) tùy ý.
Kỳ thi:
- IOI 2025 — Day 2 (6 Tháng 8., 2025)
Bình luận (1)