Hướng dẫn cho Google Code Jam 2020 - Recalculating
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích
Một phần tư \(\pi\) giúp tính toán dễ hơn
Như có thể thấy trong các hình ở đề bài, những đường phân chia vùng phân biệt được và vùng không phân biệt được luôn là các đường chéo 45 độ. Nguyên nhân là tính phân biệt được chỉ có thể thay đổi khi khả năng thu thập thông tin từ một trung tâm sửa chữa nào đó thay đổi, còn khả năng ấy chỉ thay đổi lúc đi qua các đường chéo do phép cộng trong định nghĩa khoảng cách \(L_1\). Vì đường ngang và đường dọc dễ xử lý hơn nhiều so với đường chéo, ta có thể xoay toàn bộ bài toán một góc \(\pi/4=45\) độ. Nếu xoay trực tiếp, chẳng hạn bằng cách nhân mọi điểm với ma trận xoay tương ứng, ta sẽ phải làm việc với các tọa độ không nguyên, vốn tự nó đã gây khó khăn. Phép xoay tương đương với phép chiếu lên các trục tọa độ mới; hướng của hai trục mới là các hàng của ma trận xoay, tức \((2^{-2},2^{-2})\) và \((2^{-2},-2^{-2})\). Hai vectơ \((1,1)\) và \((1,-1)\) có cùng hướng nhưng không có độ dài 1. Ta vẫn có thể chiếu lên chúng để thu được một phiên bản vừa xoay vừa đổi tỉ lệ của dữ liệu vào. May mắn là cả phép xoay lẫn phép đổi tỉ lệ đều không ảnh hưởng đến kết quả cuối cùng. Vì vậy, phép biến đổi thuận tiện là ánh xạ mỗi điểm \((x,y)\) thành \((x+y,x-y)\). Trong thế giới đã xoay và đổi tỉ lệ này, khoảng cách \(L_1\) trở thành khoảng cách \(L_\infty\); nói cách khác, các đường chéo biến thành những đường ngang và dọc cách điểm đang xét đúng \(D\) mét. Dù không nhắc lại tường minh, mọi lời giải dưới đây đều thực hiện phép biến đổi này ở bước đầu tiên.
Test Set 1
Ta có thể viết lời giải cho Test Set 1 bằng cách xét một số trường hợp và tìm công thức cho từng trường hợp. Tập các điểm mà từ đó có thể thấy một trung tâm sửa chữa là một hình vuông song song với các trục, cạnh \(2D\), có trung tâm sửa chữa ở tâm. Ta gọi nó là r-square của điểm đó.
Có ba tình huống có thể xảy ra:
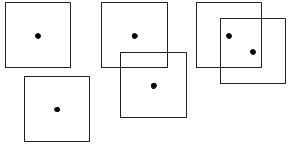
- I: Hai r-square không giao nhau.
- II: Hai r-square giao nhau và các trung tâm sửa chữa nằm ngoài r-square của nhau.
- III: Các trung tâm sửa chữa nằm trong r-square của nhau.
Tình huống I dễ xử lý nhất, vì đáp án luôn bằng 0, như Sample Case #2 minh họa.
Tình huống II được minh họa bởi Sample Case #1. Như đề bài gợi ý, ta có thể tính diện tích đỏ bằng 3 lần diện tích phần giao của hai r-square (lưu ý phần giao không nhất thiết là hình vuông), còn tổng diện tích có thể triển khai bằng tổng diện tích hai r-square, \(2\times(2D)^2\), trừ đi diện tích phần giao.
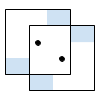
Trong tình huống III, tổng diện tích mà Principia có thể được triển khai vẫn tính giống như trước. Tuy nhiên, diện tích phân biệt được hơi khác. Tính diện tích không phân biệt được — phần được tô nổi bật trong hình dưới — có thể đơn giản hơn: nó gồm bốn bản sao của cùng một miền; sau đó ta lấy phần bù để có diện tích phân biệt được.
Test Set 2
Nhắc lại rằng \(\operatorname{Info}(p)\) là tập vị trí tương đối của các trung tâm sửa chữa có thể được thu thập từ điểm \(p\). Khi hai điểm \(p\) và \(p'\) rất gần nhau, \(\operatorname{Info}(p)\) và \(\operatorname{Info}(p')\) sẽ trông tương tự. Nếu tập trung tâm có thể thu thập từ hai điểm là như nhau — điều này đúng trong phần lớn trường hợp đối với hai điểm gần nhau — thì \(\operatorname{Info}(p')\) bằng \(\operatorname{Info}(p)\) tịnh tiến theo độ dời từ \(p\) tới \(p'\). Nhưng nếu có ít nhất một trung tâm được thu thập từ điểm này mà không được thu thập từ điểm kia thì điều đó không còn đúng; đặc biệt, hai tập Info thậm chí có thể có số điểm khác nhau.
Trước hết, ta xử lý sự thay đổi của tập trung tâm có thể thu thập bằng cách chia vùng đáng quan tâm thành các phần mà trong mỗi phần tập ấy là cố định. Với mỗi hoành độ \(X\) của một điểm đầu vào, xét mọi đường ngang \(y=X+D\) và \(y=X-D\); với mỗi tung độ \(Y\), xét mọi đường dọc \(x=Y+D\) và \(x=Y-D\). Các điểm không được bốn đường này bao quanh — chẳng hạn các điểm phía trên đường ngang cao nhất — cách quá xa mọi trung tâm nên không thể thu thập trung tâm nào; ta bỏ qua chúng trong phần phân tích còn lại. Tối đa \(4N\) đường này chia phần còn lại thành nhiều nhất \(4N^2-4N-1\) miền chữ nhật. Vì mọi cạnh của mọi r-square hoàn toàn trùng với các đường ấy, tập trung tâm có thể thu thập tại mọi điểm nằm hẳn bên trong cùng một miền là như nhau. Tập trung tâm thu được tại các điểm nằm trên đường có thể khác tập của mọi miền kề nó; tuy nhiên, mỗi đường có diện tích 0 nên xác suất Principia được triển khai ở đó bằng 0. Do đó ta bỏ qua các đường và chỉ xét điểm nằm hẳn trong miền. Với mỗi miền \(R\), tính \(A(R)\) là tổng diện tích các điểm phân biệt được trong miền và \(B(R)\) là tổng diện tích các điểm mà Principia có thể được triển khai. Đáp án là tổng \(A(R)\) trên mọi miền chia cho tổng \(B(R)\) trên mọi miền.
Cố định miền hiện tại \(C\). Theo nhận xét đầu phần, với mọi \(p,p'\) cùng thuộc \(C\), hai tập \(\operatorname{Info}(p)\) và \(\operatorname{Info}(p')\) là các bản tịnh tiến của nhau. Tính \(B(C)\) rất dễ: nó bằng diện tích \(C\) nếu Info của một điểm bất kỳ trong miền khác rỗng, và bằng 0 nếu ngược lại. Để tính \(A(C)\), ta khái quát lập luận của Test Set 1 và tìm các miền khác \(R\) sao cho \(\operatorname{Info}(q)\) là một bản tịnh tiến của \(\operatorname{Info}(p)\) với \(q\in R\) và \(p\in C\). Trong Test Set 1, điều này xảy ra ở những miền chỉ thấy một trung tâm sửa chữa, vì mọi tập chỉ có một điểm luôn là bản tịnh tiến của nhau. Để kiểm tra hai tập Info có là bản tịnh tiến và tìm độ dời thích hợp hay không, trước hết kiểm tra chúng có cùng số điểm, rồi sắp các điểm theo một thứ tự bất biến qua phép tịnh tiến, chẳng hạn theo hoành độ và dùng tung độ để phá hòa. Khi đó độ dời buộc phải là độ dời giữa điểm đầu của hai tập; cuối cùng kiểm tra độ dời ấy trên mọi cặp điểm thứ \(i\). Nếu đúng, tịnh tiến \(R\) theo độ dời tìm được để thu được \(R'\); giao \(R'\cap C\) là một hình chữ nhật gồm các điểm không phân biệt được. Lấy hợp các phần giao này trên mọi miền \(R\) sẽ cho chính xác vùng không phân biệt được trong \(C\); trừ diện tích hợp đó khỏi diện tích \(C\) để thu được \(A(C)\). Có nhiều thuật toán với hiệu quả khác nhau để tính diện tích hợp các hình chữ nhật song song trục. Với giới hạn thấp của Test Set 2, chỉ cần kỹ thuật tương tự phía trên: kéo dài các cạnh hình chữ nhật thành đường, chia thành các miền rồi kiểm tra từng miền.
Với mỗi miền \(C\), thuật toán mất \(O(N)\) để tìm \(\operatorname{Info}(p)\) cho một điểm \(p\in C\), rồi duyệt mọi miền khác \(R\) trong số \(O(N^2)\) miền, tìm \(\operatorname{Info}(q)\) tại một điểm trong \(R\), kiểm tra nó với \(\operatorname{Info}(p)\) dưới một phép tịnh tiến, và có thể tạo ra một phần giao. Mỗi \(R\) mất \(O(N)\), nên tổng là \(O(N^3)\) cho \(C\) cố định. Sau đó phải lấy hợp tối đa \(O(N^2)\) hình chữ nhật; với thuật toán đơn giản nói trên, bước này có thể mất từ \(O(N^4)\) đến \(O(N^6)\) tùy chi tiết cài đặt. Cộng trên mọi \(C\), tổng thời gian có thể đạt \(O(N^8)\), nhưng phần lớn cách cài đặt vẫn đủ nhanh trong hầu hết ngôn ngữ. Test Set 3 cần nhiều tối ưu, và chỉ cần áp dụng tối ưu đơn giản nhất trong số đó cũng đủ vượt Test Set 2. Một phương án khác là dùng thuật toán đã biết để tính diện tích hợp của \(K\) hình chữ nhật trong \(O(K\log K)\); có nhiều tài liệu về thuật toán này. Dùng trực tiếp thuật toán đó cho độ phức tạp tổng \(O(N^4\log N)\), đủ xử lý giới hạn lớn hơn nhiều so với Test Set 2.
Test Set 3
Để giải Test Set 3, ta cần nhiều tối ưu. Bước đầu tiên là tránh tính Info của mỗi miền quá một lần. Riêng thay đổi này chưa làm giảm độ phức tạp cuối cùng của thuật toán ở phần trước, nhưng là điều kiện cần cho mọi tối ưu tiếp theo.
Ta chia công việc thành hai pha. Trong pha thứ nhất, nhóm tất cả các miền có tập Info tương đương. Với mỗi miền \(C\), tính \(S:=\operatorname{Info}(p)\) cho một điểm \(p\) tùy ý trong \(C\) như trước và bỏ miền nếu \(S\) rỗng. Nếu không, sắp \(S\), rồi tịnh tiến cả \(C\) lẫn kết quả đã sắp theo điểm đầu sao cho tập sau tịnh tiến \(S'\) có gốc tọa độ làm điểm đầu. Khi đó \(S'\) là mẫu chuẩn hóa của \(C\), và hai miền có các tập Info là bản tịnh tiến của nhau sẽ cho cùng một \(S'\). Sau bước này, ta gom mọi miền đã tịnh tiến ứng với mỗi \(S'\) xuất hiện và xử lý chúng cùng nhau.
Ta có thể sắp các điểm đầu vào ngay từ đầu, rồi luôn xử lý chúng theo thứ tự ấy để mọi tập \(S\) vừa tính đã được sắp, tránh thêm một thừa số \(\log N\) vào độ phức tạp. Một cách cài đặt thô của pha này mất \(O(N^3)\) nếu dùng từ điển dựa trên bảng băm để gom tất cả miền theo từng tập \(S\). Phần dưới sẽ tối ưu tiếp pha này.
Trong pha thứ hai, với mỗi \(S'\) đã chuẩn hóa, ta phải xử lý tập các miền đã tịnh tiến tương ứng. Vì chúng đều đã được tịnh tiến theo cùng một cách chuẩn hóa, ta có thể xử lý tất cả cùng nhau: thay vì tính riêng \(A(C)\) cho từng \(C\), ta tính \(A(S'):=\sum_{C\in S'}A(C)\).
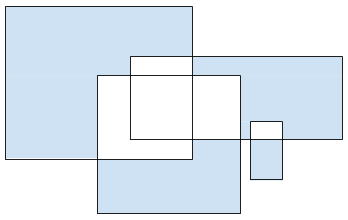
Hình dưới minh họa dữ liệu cần xử lý với một \(S'\) cố định. Có nhiều miền chữ nhật đã bị tịnh tiến, nên giờ đây một số miền có thể chồng lên nhau. Ta cần diện tích phần không xảy ra giao nhau, tức phần được đúng một hình chữ nhật phủ, được tô nổi bật trong hình. Nếu kéo dài các cạnh rồi xử lý riêng từng miền con tạo thành, thuật toán lại mất từ \(O(K^2)\) đến \(O(K^3)\) với \(K\) là số hình chữ nhật. Tuy nhiên, tổng số hình chữ nhật trên mọi \(S'\) là \(O(N^2)\) vì mỗi miền ban đầu xuất hiện trong nhiều nhất một nhóm. Vì vậy, nếu cài đặt pha hai theo cách này, tổng chi phí trên mọi \(S'\) nằm trong khoảng \(O(N^4)\) đến \(O(N^6)\).
Đến đây ta có thuật toán với pha đầu mất \(O(N^3)\) và pha hai mất tổng cộng từ \(O(N^4)\) đến \(O(N^6)\). Ta vẫn phải tối ưu thêm.
Đối với pha đầu, nếu muốn giữ \(O(N^2)\) miền mà giảm đáng kể xuống dưới \(O(N^3)\), việc xử lý mỗi miền không thể tiếp tục duyệt toàn bộ các điểm đầu vào. Xét một hàng miền cố định nằm giữa cùng hai đường ngang. Mỗi trung tâm sửa chữa có thể được thu thập từ một đoạn liên tiếp các miền trong hàng, và các trung tâm lần lượt trở nên có thể thu thập rồi không thể thu thập theo thứ tự hoành độ đã sắp. Vì vậy ta có thể duy trì danh sách các điểm biểu diễn \(S\) trong thời gian khấu hao hằng số: đẩy vào cuối danh sách các trung tâm vừa trở nên có thể thu thập và lấy khỏi đầu các trung tâm vừa trở nên không thể thu thập. Kỹ thuật này đôi khi được gọi là chasing pointers.
Đáng tiếc, như vậy vẫn chưa đủ vì mỗi \(S\) phải được tịnh tiến một lượng khác nhau, mà tịnh tiến \(S\) mất thời gian tuyến tính theo kích thước của nó. Hoàn toàn có thể xảy ra trường hợp \(S\) chứa một tỉ lệ đáng kể các điểm trong một tỉ lệ đáng kể các miền. Ta có thể làm tốt hơn bằng rolling hash của \(S\), nhờ đó lấy mã băm của mỗi \(S\) mà không tăng độ phức tạp; nhưng mã băm thu được lại không thể tịnh tiến. Mẹo cuối cùng là không băm các điểm thực, mà băm độ dời giữa mỗi điểm và điểm được xét ngay trước nó, đồng thời thêm một điểm đầu ảo có giá trị tùy ý. Những độ dời nội bộ này bất biến khi toàn bộ \(S\) được tịnh tiến; và vì điểm đầu của \(S'\) luôn là gốc tọa độ, ta chỉ cần bỏ thành phần đầu tiên khỏi mã băm. Kết quả biểu diễn duy nhất \(S'\) đã tịnh tiến, ngoại trừ khả năng va chạm băm. Thay đổi này tối ưu pha đầu xuống \(O(N^2)\).
Để tối ưu pha hai — cụ thể là việc tính các giá trị \(A(C)\) — ta dùng thuật toán tương tự thuật toán tính hợp diện tích hình chữ nhật đã nhắc ở cuối phần trước. Xét một đường quét xử lý cạnh bắt đầu và cạnh kết thúc của mỗi hình chữ nhật theo thứ tự hoành độ. Ta duy trì một cấu trúc dữ liệu biết tại mỗi tung độ có bao nhiêu hình chữ nhật phủ lên đường quét. Mỗi khi một hình chữ nhật bắt đầu, cấu trúc phải chèn một đoạn tung độ; khi nó kết thúc, cấu trúc phải xóa đoạn ấy; đồng thời cấu trúc phải truy vấn được tổng độ dài tung độ được đúng một hình chữ nhật phủ. Nhân độ dài này với chênh lệch hoành độ giữa hai điểm dừng liên tiếp của đường quét sẽ cho diện tích cần cộng vào \(A(S')\) tại mỗi điểm dừng.
Ta có thể biểu diễn cấu trúc đó hiệu quả bằng cây đoạn. Ở mỗi nút, lưu: (1) số hình chữ nhật đã xử lý phủ hoàn toàn đoạn của nút nhưng không phủ hoàn toàn đoạn của nút cha; (2) tổng độ dài trong đoạn của nút được ít nhất một hình chữ nhật phủ; (3) tổng độ dài trong đoạn của nút được ít nhất hai hình chữ nhật phủ. Hai giá trị (1) và (2) chính là dữ liệu cần lưu trong thuật toán thông thường chỉ tính diện tích hợp hình chữ nhật. Khi chèn đoạn \(I\) tại nút biểu diễn đoạn \(J\), nếu \(I\) và \(J\) không giao nhau thì không làm gì; nếu \(J\subseteq I\), chỉ tăng (1) và không đệ quy; trong mọi trường hợp còn lại, chèn đệ quy xuống các nút con. Xóa cũng tương tự: vì trong bài toán này việc xóa một đoạn nghĩa là trước đó chính đoạn ấy đã được chèn, nên khi \(J\subseteq I\), ta được bảo đảm (1) đang dương và chỉ cần giảm nó. Sau mỗi lần chèn hoặc xóa, tính lại (2) và (3). Việc tính lại mất thời gian hằng số từ (1) cùng các giá trị (2), (3) của các nút con nếu có, bằng cách xét ba trường hợp (1) bằng 0, bằng 1, hoặc ít nhất 2; chi tiết được dành làm bài tập cho người đọc. Tổng độ dài được đúng một hình chữ nhật phủ chính xác là (2) trừ (3) tại gốc cây.
Mỗi phép chèn hoặc xóa đi qua nhiều nhất \(O(\log K)\) nút và truy vấn được giải trong thời gian hằng số. Vì vậy, đường quét với cây đoạn mô tả ở trên xử lý một tập \(K\) hình chữ nhật của pha hai trong \(O(K\log K)\). Do như đã lập luận, tổng mọi \(K\) trên mọi \(S'\) là \(O(N^2)\), pha này — và toàn bộ thuật toán — chạy trong \(O(N^2\log N)\).
Ban tổ chức khuyến nghị bạn luyện gỡ lỗi lời giải mà không xem dữ liệu kiểm thử.
Nguồn
Phần phân tích này được dịch đầy đủ từ lời giải chính thức của Google Code Jam 2020, Vòng 3 — Recalculating.
Bình luận