Hướng dẫn cho Google Code Jam 2016 - Technobabble
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Test Set nhỏ
Mỗi chủ đề trong danh sách có thể được đánh dấu là “giả” hoặc “không giả”. Một cách vét cạn tự nhiên là liệt kê mọi thứ tự có thể của các chủ đề rồi chọn thứ tự có nhiều chủ đề giả nhất.
Việc kiểm tra một chủ đề có thể là giả rất đơn giản: chỉ cần xem từ thứ nhất của nó đã từng xuất hiện ở vị trí thứ nhất trước đó hay chưa, và từ thứ hai đã từng xuất hiện ở vị trí thứ hai trước đó hay chưa. Lưu ý rằng việc đánh dấu một chủ đề là giả không làm thay đổi khả năng đánh dấu các chủ đề phía sau, nên với chiến lược này, hễ có thể thì luôn tính chủ đề đó là giả là tối ưu.
Tuy nhiên, có \(N!\) thứ tự, quá nhiều ngay cả khi \(N \le 16\) (\(16!\) vào khoảng 21 nghìn tỷ). Ta cần cách tốt hơn. Thay vì tối đa hóa số chủ đề giả, hãy xét bài toán ngược lại: tối thiểu hóa số chủ đề không giả.
Nhận xét then chốt là mọi tập chủ đề không giả khả dĩ phải chứa mỗi từ thứ nhất ít nhất một lần và mỗi từ thứ hai ít nhất một lần; nếu không, sẽ có một chủ đề giả chứa một từ mà người giả mạo chưa thể dùng. Ngược lại, bất kỳ tập nào chứa mọi từ thứ nhất và mọi từ thứ hai ít nhất một lần đều có thể là tập chủ đề không giả: chỉ cần đặt tất cả chủ đề trong tập đó lên đầu danh sách. Vì vậy, câu hỏi trở thành: Tập chủ đề nhỏ nhất chứa mỗi từ thứ nhất ít nhất một lần và mỗi từ thứ hai ít nhất một lần là gì?
Với Test Set nhỏ, ta liệt kê mọi tập con của các chủ đề và chọn tập ít phần tử nhất nhưng phủ mọi từ ở cả hai vị trí. Có \(2^N\) tập con, nên thuật toán chạy theo thời gian mũ; với \(N=16\) chỉ có \(2^{16}=65\,536\) tập, hoàn toàn chấp nhận được.
Test Set lớn
Ở Test Set lớn, thuật toán thời gian mũ không còn dùng được. Bài toán thực ra có lời giải thời gian đa thức, và có thể diễn đạt bằng lý thuyết đồ thị.
Xem mỗi từ là một đỉnh trong đồ thị hai phía, còn mỗi chủ đề là một cạnh nối hai đỉnh tương ứng. Dữ liệu bên dưới tương ứng với đồ thị trong hình; màu các cạnh sẽ được giải thích ngay sau đó.
HYDROCARBON COMBUSTION
BIOMASS COMBUSTION
QUAIL COMBUSTION
QUAIL BEHAVIOR
QUAIL CONTAMINATION
GROUNDWATER CONTAMINATION
GROUNDWATER HYDROLOGY
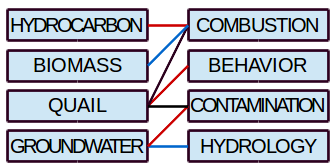
Bài toán trên đồ thị chính là tìm phủ cạnh nhỏ nhất: tập cạnh nhỏ nhất sao cho mỗi đỉnh kề với ít nhất một cạnh được chọn. Nó tương ứng chính xác với tập chủ đề nhỏ nhất chứa mọi từ thứ nhất và mọi từ thứ hai ít nhất một lần.
Phủ cạnh nhỏ nhất liên hệ với ghép cặp cực đại của đồ thị, tức tập cạnh lớn nhất không có chung đầu mút: chúng luôn có cùng số thành phần liên thông. Nếu điều này chưa hiển nhiên, hãy thử vẽ vài đồ thị và tìm phản ví dụ. Ta còn nhận thấy mọi đỉnh không nằm trong một ghép cặp cực đại phải kề với một đỉnh nằm trong ghép cặp; nếu không, ta có thể thêm cặp đó vào ghép cặp và làm nó lớn hơn. Từ các nhận xét này, ta dùng thuật toán hai bước để tìm phủ cạnh nhỏ nhất:
- Tìm ghép cặp hai phía có lực lượng lớn nhất. Việc này làm được trong thời gian đa thức, chẳng hạn bằng Ford–Fulkerson hoặc Hopcroft–Karp. Một ghép cặp như vậy được tô đỏ trong hình.
- Duyệt các cạnh còn lại và tham lam thêm một cạnh mỗi khi nó nối tới một đỉnh chưa được dùng. Các cạnh được thêm ở bước này được tô xanh trong hình.
Thực ra ta chỉ cần kích thước phủ cạnh nhỏ nhất: số cạnh trong ghép cặp cực đại cộng với số đỉnh không thuộc ghép cặp đó. Đáp án cuối cùng bằng tổng số cạnh (chủ đề) trừ kích thước phủ cạnh nhỏ nhất. Nếu gọi tổng số đỉnh là \(V\) và kích thước ghép cặp cực đại là \(|M|\), giá trị này là
Phần trình bày dựa trên phân tích chính thức của Google Code Jam 2016, Vòng 1B.
Bình luận