Hướng dẫn cho Google Code Jam 2014 - Proper Shuffle
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích: Proper Shuffle
Bài toán này hơi khác thường đối với một bài thi lập trình vì lời giải không cần đúng tuyệt đối. Thực tế, ngay cả lời giải tốt nhất đôi khi vẫn có thể nhận Wrong Answer do ngẫu nhiên. Dù vậy, tồn tại các lời giải phân loại với xác suất thành công cao xem một hoán vị được tạo bởi thuật toán BAD hay GOOD. Một cách là sinh nhiều mẫu hoán vị BAD và GOOD rồi xem phân phối tần suất của chúng theo một số hàm chấm điểm. Khi biết các phân phối điểm, ta có thể tạo một bộ phân loại đơn giản. Lời giải nghe có vẻ đơn giản, nhưng lượng phân tích cùng số lần thử-sai cần để tìm một hàm điểm tốt không hề nhỏ. Phần còn lại giải thích trực giác để xây dựng một hàm như vậy.
Tại sao thuật toán GOOD lại TỐT?
Nếu một hoán vị của \(N\) số là GOOD, xác suất mỗi số kết thúc tại một vị trí cho trước đúng bằng \(1/N\). Trong thuật toán GOOD, điều này đúng ở mọi bước. Ở bước đầu, xác suất mỗi số rơi vào vị trí đầu là \(1/N\), vì dãy ban đầu có \(N\) phần tử. Sau đó vị trí đầu được cố định — nó không còn bị đổi ở các bước sau — nên ở bước hai ta bỏ qua nó và chỉ xét \(N-1\) số còn lại. Một số được chọn ở bước hai khi nó không bị chọn ở bước đầu, xác suất \((N-1)/N\), rồi được chọn trong bước hai, xác suất \(1/(N-1)\). Tích hai xác suất là \(1/N\). Tiếp tục lập luận này, cuối cùng mỗi số có xác suất đều \(1/N\) để nằm ở bất kỳ vị trí nào.
Tại sao thuật toán BAD lại XẤU?
Trong thuật toán BAD, ở bước \(i\), ta chọn một vị trí ngẫu nhiên từ \(0\) đến \(N-1\) để tráo đổi với phần tử ở vị trí \(i\). Nếu ta chọn một vị trí \(j < i\), phần tử đó có thể bị tráo đổi tiếp về các vị trí lớn hơn \(i\) ở các bước sau, nhưng không bao giờ quay lại các vị trí nhỏ hơn \(i\). Điều này tạo ra sự sai lệch.
Hãy xem xét tần suất số \(i\) (vị trí ban đầu) kết thúc ở vị trí \(j\) (trong hoán vị kết quả). Hình ảnh dưới đây minh họa điều này với \(N=100\), chạy mỗi thuật toán 20,000 lần. Trục x là vị trí ban đầu, trục y là vị trí kết thúc. Màu càng đậm nghĩa là tần suất càng cao.
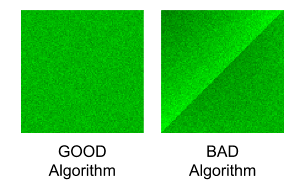
Thuật toán GOOD phân phối đều các số, trong khi thuật toán BAD có xu hướng đẩy các số có chỉ số nhỏ ban đầu sang các vị trí cao hơn trong hoán vị (vùng đậm ở góc trên bên trái).
Bộ phân loại đơn giản
Dựa trên nhận xét trên, ta có thể dùng một hàm điểm đơn giản: đếm số lượng phần tử trong hoán vị kết thúc ở vị trí nhỏ hơn hoặc bằng vị trí ban đầu của nó.
def f(S):
  score = 0
  for i in 0 .. N-1:
    if S[i] <= i:
      score++
  return score
Với \(N=1000\), thuật toán GOOD sẽ cho điểm quanh mức \(500\). Thuật toán BAD sẽ cho điểm thấp hơn đáng kể vì các số nhỏ có xu hướng di chuyển đến vị trí lớn hơn. Đồ thị phân phối điểm như sau:
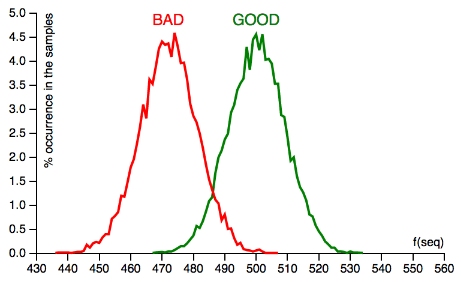
Thuật toán GOOD tập trung quanh \(500\), trong khi BAD tập trung quanh \(472\). Ta có thể xây dựng bộ phân loại:
if f(S) < (472 + 500) / 2:
  S is produced by the BAD algorithm
else:
  S is produced by the GOOD algorithm
Điều tiện lợi khi là lập trình viên là không phải lúc nào ta cũng cần chứng minh hình thức. Ta có thể ước lượng độ chính xác bằng cách sinh nhiều hoán vị GOOD/BAD, mỗi loại có xác suất \(50\%\), rồi đếm số hoán vị được phân loại đúng. Mô phỏng cho thấy bộ phân loại đơn giản đạt khoảng \(94{,}05\%\) độ chính xác. Nó đủ để phân loại đúng ít nhất \(109\) trong \(120\) trường hợp với xác suất khoảng \(94{,}58\%\). Nếu không may dữ liệu của bạn rơi vào \(5{,}42\%\) còn lại, bạn có thể tải một dữ liệu khác. Tuy nhiên, phó mặc \(5{,}42\%\) cho may rủi vẫn có vẻ quá nhiều. Nếu chỉ được nộp một lần thì sao? Phần tiếp theo trình bày một trong nhiều ý tưởng cho xác suất thành công cao hơn.
Bộ phân loại Naive Bayes
Để đạt độ chính xác cao hơn, ta có thể dùng định lý Bayes. Ta muốn tìm \(P(GOOD | S)\), xác suất thuật toán GOOD được dùng khi thấy hoán vị \(S\). Theo định lý Bayes:
P(GOOD | S) = P(S | GOOD) * P(GOOD) / (P(S | GOOD) * P(GOOD) + P(S | BAD) * P(BAD))
P(GOOD | S) = P(S | GOOD) / (P(S | GOOD) + P(S | BAD))
Ở đây, \(P(S\mid GOOD)\) là xác suất sinh ra \(S\) khi dùng GOOD; \(P(S\mid BAD)\) là xác suất sinh ra \(S\) khi dùng BAD; còn \(P(GOOD)\) và \(P(BAD)\) là xác suất chọn từng thuật toán. Vì hai thuật toán được chọn với xác suất bằng nhau, công thức được rút gọn như trên. Nếu \(P(GOOD\mid S)>0{,}5\), \(S\) có khả năng do GOOD sinh ra hơn. Thay vế phải vào bất đẳng thức và biến đổi đại số cho ta điều kiện \(P(S\mid GOOD)>P(S\mid BAD)\).
Ta biết chính xác \(P(S\mid GOOD)=1/N!\) vì có \(N!\) hoán vị. Do đó chỉ cần tìm \(P(S\mid BAD)\). Nếu tính được đại lượng này, ta sẽ có bộ phân loại tối ưu; đáng tiếc, chưa biết cách hiệu quả để tính chính xác nó, và thuật toán tốt nhất đã biết là không khả thi với \(N=1000\). Vì thế, ta mượn một ý tưởng từ học máy và đưa ra giả định Naive Bayes: chuyển động của mỗi phần tử là độc lập.
P(S | BAD) ≈ P(S[0] | BAD) * P(S[1] | BAD) * ... * P(S[N-1] | BAD)
Ở đây, \(P(S[0]\mid BAD)\) là xác suất phần tử đầu của một hoán vị BAD ngẫu nhiên đúng là \(S[0]\). Nếu không có giả định độc lập, ta phải dùng các số hạng như \(P(S[1]\mid BAD+S[0])\): xác suất phần tử thứ hai đúng là \(S[1]\) với điều kiện dùng BAD và phần tử đầu đã là \(S[0]\). Naive Bayes cho phép bỏ điều kiện phụ ấy, làm phép tính khả thi nhưng không hoàn toàn chính xác.
Để công bằng, ta cũng áp dụng giả định đơn giản hóa ấy cho \(P(S\mid GOOD)\). Việc này dễ: dưới GOOD, mỗi phần tử có xác suất \(1/N\) tới từng vị trí, nên \(P(S\mid GOOD)=1/N^N\) bất kể \(S\).
Bây giờ hãy cài bộ phân loại. Gọi \(P_k[i][j]\) là xác suất số \(i\) nằm ở vị trí \(j\) sau \(k\) bước của BAD. Ta cần \(k=N\). Có thể tính \(P_k\) từ \(P_{k-1}\) trong \(O(N^2)\) bằng cách mô phỏng mọi phép đổi chỗ. \(P_0\) là ma trận đơn vị vì chưa có gì di chuyển. Trong mã giả dưới đây, prev[i][j] chính là \(P_k[i][j]\).
Mã giả tính ma trận xác suất:
  prev[i][i] = 1.0 for all i, otherwise 0.0  // An identity matrix.
  pmove = 1.0 / N  // Probability of a number being swapped.
  pstay = 1.0 - pmove  // Probability of a number not being swapped.

  for k in 0 .. N-1:
      for i in 0 .. N-1:
          next[i][k] = 0
          for j in 0 .. N-1:
              next[i][k] += prev[i][j] * pmove  // (1)
              if j != k:
                  next[i][j] = prev[i][j] * pstay +
                               prev[i][k] * pmove  // (2)
      Copy next to prev
Trong chú thích (1), xác suất để số \(i\) ở vị trí \(k\) ở bước kế tiếp bằng xác suất nó ở vị trí \(j\) trước đó nhân xác suất được chuyển tới \(k\). Trong chú thích (2), xác suất số \(i\) ở lại vị trí \(j\) bằng xác suất trước đó nó đã ở \(j\) nhân xác suất ở lại, cộng xác suất trước đó nó ở \(k\) nhân xác suất được chuyển tới \(j\).
Thuật toán trên chạy trong \(O(N^3)\). Nó có thể mất vài giây, hoặc vài phút trong ngôn ngữ kịch bản chậm. Tuy nhiên, ta có thể chạy ngoại tuyến trước khi tải dữ liệu và lưu ma trận xác suất vào tệp. Nếu cần, thuật toán cũng có thể tối ưu xuống \(O(N^2)\); xem lời giải GCJ 2014 Round 1A của Gennady Korotkevich để biết một cách cài đặt.
Tiếp theo, tính xác suất xấp xỉ cho \(P(S\mid BAD)\):
  bad_prob = 1.0
  for i in 0 .. N:
    bad_prob = bad_prob * prev[S[i]][i]
Và so sánh:
  good_prob = 1.0 / N^N
  if good_prob > bad_prob:
    S is produced by the GOOD algorithm
  else:
    S is produced by the BAD algorithm
Mã giả trên thao tác với các xác suất cực nhỏ và có thể bị tràn dưới khi cài đặt. Có thể tránh bằng cách cộng logarithm các xác suất thay vì nhân chúng.
Theo thực nghiệm, bộ phân loại Naive Bayes đạt khoảng \(96{,}2\%\) độ chính xác; xác suất phân loại đúng ít nhất \(109\) trong \(120\) trường hợp là \(99{,}8\%\).
Editorial này đã mô tả hai phương pháp. Nhiều khả năng còn các lời giải tốt hơn nữa, và chúng tôi mời bạn đọc thử tìm ra chúng.
Dựa trên phân tích chính thức của Google Code Jam.
Bình luận