Hướng dẫn cho Google Code Jam 2011 - Spinning Blade
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích: Spinning Blade
Công thức đơn giản nhất cho trọng tâm của một lưỡi dao là
trong đó \(P_i\) là vị trí ô \(i\) so với một vị trí cố định như góc trên bên trái, \(\operatorname{Mass}_i\) là khối lượng ô \(i\), và \(i\) chạy qua mọi ô của lưỡi dao.
Có thể tính độc lập tọa độ \(X\) và \(Y\) của trọng tâm. Tâm hình học cũng dễ tính; tọa độ \(X\) là trung bình của tọa độ \(X\) nhỏ nhất và lớn nhất trong lưỡi dao. Để tránh số thực và sai số, thay vì kiểm tra
ta kiểm tra
và tương tự cho \(Y\).
Duyệt mọi góc trên bên trái, mọi kích thước, rồi mọi ô của lưỡi dao (bỏ bốn góc) tốn \(O(N^5)\), với \(N\) là cận chung của \(R,C\). Cách này đủ cho dữ liệu nhỏ nhưng không đủ cho dữ liệu lớn.
Trước khi xét dữ liệu lớn, cần lưu ý tràn số. Có thể ước lượng vế trái bằng \(2N^2\cdot N\cdot\max W\): hai lần số ô, nhân tọa độ \(X_i\) lớn nhất, nhân khối lượng ô lớn nhất. Dữ liệu nhỏ vừa số nguyên 32 bit; dữ liệu lớn nên dùng số nguyên 64 bit. Ban tổ chức từng cân nhắc giới hạn \(D\) là \(10^{18}\); các cách xử lý cả giới hạn rất lớn ấy nằm ở cuối bài.
Có \(O(N^3)\) lưỡi dao cần xét, nên để xử lý dữ liệu lớn, ta tính các đại lượng trọng tâm của mỗi lưỡi dao trong \(O(1)\) bằng tiền xử lý.
Ta tiền xử lý \(\sum_i\operatorname{Mass}_iX_i\) và \(\sum_i\operatorname{Mass}_i\) cho mọi hình chữ nhật có hai góc \((0,0)\) và \((x,y)\). Bắt đầu với hình \((0,0)\)–\((1,1)\), tức ô đầu tiên. Hình \((0,0)\)–\((1,2)\) được ghép từ hình vừa biết và dải \((0,1)\)–\((1,2)\). Khi tăng \(Y\) từng đơn vị, mọi hình chữ nhật tương ứng được tính trong thời gian hằng số.
Tương tự, hình \((0,0)\)–\((2,1)\) được ghép từ hình \((0,0)\)–\((1,1)\) và dải \((1,0)\)–\((2,1)\). Ở bước kế tiếp ta gặp cấu hình sau.
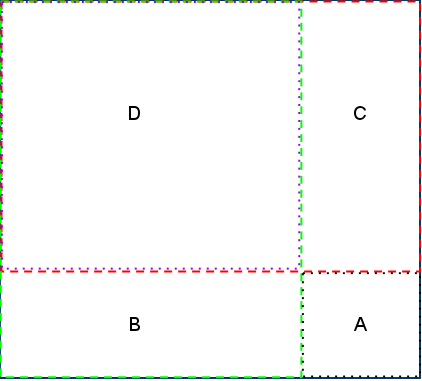
Hai hình chữ nhật \(B,C\) chồng nhau tại \(D\). Biết các tổng cho \(A,B,C,D\), tổng cho toàn hình \(R\) là
vì \(D\) bị cộng hai lần. Công thức dùng được cho cả đại lượng trọng tâm lẫn tổng khối lượng, cho mọi hình từ \((0,0)\)–\((2,2)\) đến \((0,0)\)–\((X,Y)\). Tiền xử lý tốn \(O(N^2)\) vì mỗi ô chỉ được xét một lần.
Để lấy tổng trên hình vuông có góc \((x_1,y_1)\) và \((x_2,y_2)\), đặt:
- \(A\): hình vuông cần tìm;
- \(B\): hình chữ nhật \((0,0)\)–\((x_1,y_2)\);
- \(C\): hình chữ nhật \((0,0)\)–\((x_2,y_1)\);
- \(R\): hình chữ nhật \((0,0)\)–\((x_2,y_2)\);
- \(D\): hình chữ nhật \((0,0)\)–\((x_1,y_1)\).
Cùng lập luận trên cho \(R=A+B+C-D\), hay \(A=R+D-B-C\). Sau tiền xử lý, mọi đại lượng của hình vuông được tính trong \(O(1)\); trừ giá trị ở bốn góc sẽ được lưỡi dao. Tổng thời gian là \(O(N^2+N^3)\), đủ nhanh với \(N\le500\).
Ghi chú bên lề
Một cách khác là thử mọi góc trên bên trái rồi mở rộng kích thước từng đơn vị về phía dưới bên phải, dùng \(O(N)\) phép tính mỗi bước để cập nhật các tổng. Tổng thời gian là \(O(N^4)\). Dù \(N\) tới \(500\), thực tế ít hơn nhiều so với \(500^4\) phép tính vì phần lớn góc không thể mở rộng tới \(N\); giới hạn kích thước tệp còn bảo đảm nhiều nhất hai trường hợp cực đại. Vì vậy cách này kịp trên phần lớn máy và ngôn ngữ.
Xử lý tràn số
Nếu giới hạn \(D\) lớn hơn:
- Dùng số nguyên lớn. Cách này tốn hiệu năng, nhưng với lời giải \(O(N^3)\) vẫn có thể đủ nhanh.
- Nhận ra \(D\) không ảnh hưởng. Cộng cùng khối lượng \(D\) vào mọi ô giống như đặt lên trên một tấm mới có mọi ô nặng \(D\). Trọng tâm tổng hợp nằm giữa trọng tâm hai tấm, nên ở giữa khi và chỉ khi tấm ban đầu có trọng tâm ở giữa. Về hình thức, khi cộng \(D\) vào mỗi \(\operatorname{Mass}_i\), hai vế cùng tăng \(2\operatorname{AvgX}\cdot\operatorname{NumberOfCells}\), trong đó \(\operatorname{AvgX}\) là tọa độ \(X\) trung bình của ô trong lưỡi dao. Vì vậy có thể đặt \(D=1\) và dùng số nguyên 32 bit.
- Cũng có thể đặt \(D=0\). Điều này có vẻ nguy hiểm vì công thức trọng tâm ban đầu sẽ chia cho \(0\); hãy tự xét vì sao nó vẫn đúng.
- Có thể bỏ qua tràn nếu trình biên dịch bảo đảm số học mô-đun khi tràn. Vì \(D\) triệt tiêu ở hai vế, nó cũng triệt tiêu theo mô-đun MAXINT, miễn phần còn lại không tràn. Nhưng cần hiểu rõ công cụ: C++ bảo đảm điều này cho số nguyên không dấu, không bảo đảm cho số nguyên có dấu; trình biên dịch có thể tối ưu với giả định số có dấu không tràn và phá mã dựa vào số học mô-đun.
Dựa trên phân tích chính thức của Google Code Jam.
Bình luận