Hướng dẫn cho Google Code Jam 2009 - Stock Charts
Chép code từ bài hướng dẫn để nộp bài là hành vi có thể dẫn đến khóa tài khoản.
Phân tích: Stock Charts
Không có gì quá ngạc nhiên, tác giả của bài toán này đã nảy ra ý tưởng khi đang đọc bản tóm tắt kinh tế cuối năm của một tờ báo địa phương, nhìn thấy một số biểu đồ lồng nhau trong đó và tự hỏi làm thế nào để giảm thiểu số lượng biểu đồ cần thiết.
Biểu đồ và Đồ thị có hướng không chu trình (DAG)
Xét hai biểu đồ đơn giản: \(A\) và \(B\). Chúng có thể liên quan với nhau theo một trong ba cách: tất cả các giá trị của \(A\) có thể nhỏ hơn hẳn tất cả các giá trị của \(B\) (\(A < B\)), trong trường hợp đó chúng có thể xuất hiện trên cùng một biểu đồ lồng nhau; các đường của chúng có thể cắt nhau (\(A \setminus B\)), trong trường hợp đó chúng không thể xuất hiện trên cùng một biểu đồ lồng nhau; hoặc tất cả các giá trị của \(A\) có thể lớn hơn hẳn tất cả các giá trị của \(B\) (\(A > B\)), trong trường hợp đó chúng có thể xuất hiện trên cùng một biểu đồ lồng nhau.
Với loại quan hệ này, chúng ta có thể xây dựng một đồ thị, trong đó các nút là các biểu đồ đơn giản và có một cạnh từ \(A\) đến \(B\) nếu và chỉ nếu \(A > B\). Điều này cho chúng ta một đồ thị có hướng, không chu trình (DAG) và nó chính là bao đóng bắc cầu (không phản xạ) của chính nó. Bất kỳ đường đi có hướng nào trong DAG đều đại diện cho một biểu đồ lồng nhau hợp lệ. Để giải quyết vấn đề, chúng ta muốn tìm số lượng đường đi tối thiểu cần thiết sao cho tất cả các nút đều thuộc về đúng một đường đi.
Làm thế nào để chúng ta tìm các đường đi? Chúng ta có thể bắt đầu từ một biểu đồ tương đối cao, sau đó tìm một biểu đồ bên dưới nó và tiếp tục thêm các biểu đồ thấp hơn, cho đến khi không thể tìm thêm được nữa. Điều này hoàn thành biểu đồ lồng nhau đầu tiên của chúng ta. Chúng ta bắt đầu quá trình tương tự cho đường đi thứ hai, và cứ tiếp tục như vậy. Trong bất kỳ bước nào, có thể có nhiều lựa chọn cho biểu đồ tiếp theo mà chúng ta có thể sử dụng. Để giảm thiểu số lượng đường đi, chúng ta cần đưa ra lựa chọn tốt trong mỗi bước.
Và đây là khoảnh khắc "Aha!" của bài toán này.
Giải pháp từ ghép nối cực đại (Maximum Matching)
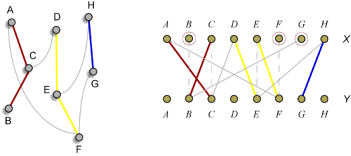
Đối với DAG có \(n\) điểm, chúng ta tạo một đồ thị hai phía với \(n\) điểm ở mỗi bên. Vẽ một cạnh từ \(X_A\) đến \(Y_B\) nếu quan hệ \(A > B\) giữ nguyên, tức là \(B\) có thể là biểu đồ tiếp theo bên dưới \(A\). Hãy quan sát cách bất kỳ đường đi nào trong DAG tương ứng với một chuỗi các cạnh trong đồ thị hai phía; và cách bất kỳ phép ghép nối nào của đồ thị hai phía tương ứng với một cách phân chia DAG thành các đường đi. Bất kỳ điểm \(X_A\) nào không được ghép nối ở phía bên trái tương ứng với điểm thấp nhất trên một đường đi (biểu đồ thấp nhất trên một biểu đồ lồng nhau). Mỗi đường đi có đúng một điểm như vậy. Chúng ta muốn giảm thiểu số lượng đường đi, tương đương với việc giảm thiểu số lượng điểm không được ghép nối ở phía bên trái. Nghĩa là, chúng ta muốn tìm ghép nối cực đại trên đồ thị hai phía.
Dưới đây là giải pháp của giám khảo bằng C++.
namespace Solver {
int N,K;
bool cbn[111][111]; // can be next
int prev[111];
bool visited[111];

bool FindNextDfs(int a) {
  if(a<0) return true;
  if(visited[a]) return false;
  visited[a]=true;
  for (int i=0;i<N;i++) if(cbn[a][i]) {
      if(FindNextDfs(prev[i])) {
        prev[i]=a;
        return true;
      }
    }
  return false;
}

int Solve(const vector<vector<int> >& stock) {
  N=stock.size(); K=stock[0].size();
  int i,j,k;
  for(i=0;i<N;i++) {
    for(j=0;j<N;j++) {
      if(i==j) cbn[i][j]=false;
      else {
        cbn[i][j]=true;
        for(k=0;k<K;k++)
          if(stock[i][k]<=stock[j][k]) cbn[i][j]=false;
      }
    }
  }
  memset(prev, -1, sizeof(prev));
  int ret=0;
  for(i=0;i<N;i++) {
    memset(visited, 0, sizeof(visited));
    if(!FindNextDfs(i)) ret++;
  }
  return ret;
}
Lưu ý rằng đây thực sự là chương trình ghép nối hai phía. Chúng tôi đặt tên các biến như thể chúng tôi thực sự đang xây dựng tập hợp các đường đi và không biết về đồ thị hai phía. Trên thực tế, việc xem xét lại điều này mà không có khái niệm ghép nối hai phía trong đầu là một bài tập đáng giá.
Điều này hoàn thành giải pháp cho bài toán của chúng ta. Nhưng chúng ta có thể tiếp tục với nhiều câu chuyện hơn.
Nền tảng lý thuyết
Trong tổ hợp, các DAG được gọi là tập sắp thứ tự bộ phận (partially ordered sets), hay posets. Một đường đi có hướng được gọi là một chuỗi (chain) trong poset. Một tập độc lập trong DAG, tương ứng với một tập các điểm mà không có quan hệ '\(>\)' nào giữa bất kỳ hai điểm nào trong số chúng, được gọi là một phản chuỗi (anti-chain). Bài toán của chúng ta khi đó là: cho một poset, tìm số lượng chuỗi tối thiểu cần thiết để bao phủ tất cả các điểm.
Nếu chúng ta thấy một phản chuỗi có kích thước \(\alpha\), chúng ta cần ít nhất \(\alpha\) chuỗi để bao phủ tập hợp, vì mỗi chuỗi có thể chứa tối đa một trong các điểm này. Giả sử chúng ta tìm thấy phản chuỗi lớn nhất có kích thước \(\alpha^*\), chúng ta biết câu trả lời phải ít nhất là \(\alpha^*\). Liệu điều này có đủ không?
Chúng ta đã sẵn sàng để giới thiệu một trong những định lý kinh điển trong tổ hợp.
Định lý (Dilworth 1950): Trong một poset, số lượng chuỗi tối thiểu cần thiết để bao phủ toàn bộ tập hợp bằng kích thước của phản chuỗi lớn nhất.
Định lý Dilworth có liên quan chặt chẽ với các định lý kinh điển khác trong tổ hợp. Trên thực tế, nó tương đương với định lý về hôn nhân của Hall trên đồ thị hai phía và định lý luồng cực đại - lát cắt cực tiểu (max-flow-min-cut).
Con số trong định lý Dilworth (một cách tự nhiên) được gọi là chiều rộng (width) của poset. Thuật toán của chúng ta ở trên do đó tìm thấy chiều rộng của một poset. Những độc giả quan tâm có thể tìm thấy, trong tệp dữ liệu đầu vào của chúng ta, các bản sao bị biến đổi của các poset sau:
- Lưới Boolean đầy đủ (complete Boolean lattice): Tất cả \(2^k\) tập con của một tập hợp có \(k\) phần tử, trong đó \(A > B\) nếu \(B\) là tập con của \(A\). Tất cả các tập con kích thước \(\lceil k/2 \rceil\) tạo thành một phản chuỗi cực đại có kích thước \(\binom{k}{\lceil k/2 \rceil}\), và thực sự chúng ta có thể phân chia lưới Boolean thành ngần ấy chuỗi. (Đây được gọi là định lý Sperner.)
- Tất cả các số nguyên từ \(1\) đến \(n\), \(A > B\) nếu \(A\) là bội số của \(B\). Tập hợp tất cả các số nguyên tố có vẻ là một phản chuỗi lớn. Nhưng nó không đủ lớn. Chúng tôi để lại việc chứng minh chiều rộng của poset này là \(\lceil n/2 \rceil\) như một bài tập.
Thông tin thêm
Nguồn
Bản dịch dựa trên phân tích chính thức của Google Code Jam 2009 - Round 2 - Stock Charts, thuộc kho Google Coding Competitions (Apache-2.0).
Bình luận