| # | Bài tập | Điểm | Thời gian: | Giới hạn bộ nhớ |
|---|---|---|---|---|
| 1 | IOI 2024 - Nile | 100 (p) | 2.0s | 2G |
| 2 | IOI 2024 - Message | 100 (p) | 3.0s | 2G |
| 3 | IOI 2024 - Tree | 100 (p) | 2.0s | 2G |
Bạn muốn vận chuyển \(N\) cổ vật qua sông Nile. Các cổ vật được đánh số từ \(0\) đến \(N-1\). Khối lượng của cổ vật \(i\) (\(0 \leq i < N\)) là \(W[i]\).
Để vận chuyển các cổ vật, bạn dùng nhiều thuyền chuyên dụng. Mỗi chiếc thuyền có thể mang nhiều nhất hai cổ vật.
Để vận chuyển một cổ vật, bạn phải trả chi phí phụ thuộc vào số lượng cổ vật trên cùng một chiếc thuyền đó. Chi phí để vận chuyển cổ vật \(i\) (\(0 \leq i < N\)) là:
Lưu ý rằng, trong trường hợp thứ hai, bạn phải trả chi phí cho cả hai cổ vật trên chiếc thuyền đó. Cụ thể, nếu bạn quyết định vận chuyển cổ vật \(p\) và \(q\) (\(0 \leq p < q < N\)) trên cùng một chiếc thuyền, bạn phải trả chi phí \(B[p] + B[q]\).
Vận chuyển duy nhất một cổ vật trên một chiếc thuyền luôn luôn có chi phí đắt hơn vận chuyển cổ vật đó cùng với một cổ vật khác trên thuyền, tức là \(B[i] < A[i]\) với mọi \(i\) thoả mãn \(0 \leq i < N\).
Không may, dòng sông rất khó dự đoán và giá trị \(D\) thay đổi thường xuyên. Nhiệm vụ của bạn là trả lời \(Q\) câu hỏi, đánh số từ \(0\) đến \(Q-1\). Các câu hỏi được mô tả bằng một mảng \(E\) có độ dài \(Q\). Câu trả lời cho câu hỏi \(j\) (\(0 \leq j < Q\)) là tổng chi phí nhỏ nhất để vận chuyển tất cả \(N\) cổ vật khi giá trị \(D\) bằng \(E[j]\).
Bạn cần cài đặt hàm sau.
std::vector<long long> calculate_costs(
std::vector<int> W, std::vector<int> A,
std::vector<int> B, std::vector<int> E);
| Subtask | Điểm | Các ràng buộc thêm |
|---|---|---|
| 1 | \(6\) | \(Q \leq 5\); \(N \leq 2000\); \(W[i] = 1\) với mọi \(i\) thoả mãn \(0 \leq i < N\) |
| 2 | \(13\) | \(Q \leq 5\); \(W[i] = i+1\) với mọi \(i\) thoả mãn \(0 \leq i < N\) |
| 3 | \(17\) | \(Q \leq 5\); \(A[i] = 2\) và \(B[i] = 1\) với mọi \(i\) thoả mãn \(0 \leq i < N\) |
| 4 | \(11\) | \(Q \leq 5\); \(N \leq 2000\) |
| 5 | \(20\) | \(Q \leq 5\) |
| 6 | \(15\) | \(A[i] = 2\) và \(B[i] = 1\) với mọi \(i\) thoả mãn \(0 \leq i < N\) |
| 7 | \(18\) | Không có ràng buộc nào thêm. |
Xét lời gọi hàm sau.
calculate_costs([15, 12, 2, 10, 21],
[5, 4, 5, 6, 3],
[1, 2, 2, 3, 2],
[5, 9, 1])
Trong ví dụ này, ta có \(N = 5\) cổ vật và \(Q = 3\) câu hỏi.
Trong câu hỏi thứ nhất, \(D = 5\). Bạn có thể vận chuyển cổ vật \(0\) và \(3\) trên cùng một chiếc thuyền (vì \(|15 - 10| \leq 5\)) và cổ vật còn lại có thể được vận chuyển trên các chiếc thuyền riêng biệt. Làm như vậy được tổng chi phí nhỏ nhất để vận chuyển tất cả cổ vật là \(1+4+5+3+3 = 16\).
Trong câu hỏi thứ hai, \(D = 9\). Bạn có thể vận chuyển cổ vật \(0\) và \(1\) trên cùng một chiếc thuyền (vì \(|15 - 12| \leq 9\)) và vận chuyển cổ vật \(2\) và \(3\) trên cùng một chiếc thuyền (vì \(|2 - 10| \leq 9\)). Cổ vật còn lại có thể được vận chuyển trên một chiếc thuyền riêng biệt. Làm như vậy được tổng chi phí nhỏ nhất để vận chuyển tất cả cổ vật là \(1+2+2+3+3 = 11\).
Trong câu hỏi cuối cùng, \(D = 1\). Bạn cần vận chuyển từng cổ vật trên một chiếc thuyền riêng biệt. Làm như vậy được tổng chi phí nhỏ nhất để vận chuyển tất cả cổ vật là \(5+4+5+6+3 = 23\).
Do đó, hàm cần trả về \([16, 11, 23]\).
Định dạng dữ liệu vào:
N
W[0] A[0] B[0]
W[1] A[1] B[1]
...
W[N-1] A[N-1] B[N-1]
Q
E[0]
E[1]
...
E[Q-1]
Định dạng kết quả ra:
R[0]
R[1]
...
R[S-1]
Trong đó, \(S\) là độ dài của mảng \(R\) trả về bởi hàm calculate_costs.
Nguồn: Olympic Tin học Quốc tế (IOI) 2024. Bản dịch tiếng Việt chính thức do ban tổ chức cung cấp.
Aisha và Basma là hai người bạn có liên hệ với nhau. Aisha có một thông điệp \(M\) muốn gửi cho Basma, đó là một chuỗi \(S\) bit (tức là gồm các số \(0\) hoặc số \(1\)). Aisha giao tiếp với Basma bằng cách gửi cho cô ấy các gói tin. Một gói tin là một chuỗi \(31\) bit được đánh chỉ số từ \(0\) đến \(30\). Aisha muốn gửi thông điệp \(M\) cho Basma bằng cách gửi cho cô ấy một số lượng gói tin nhất định.
Không may, Cleopatra đã can thiệp vào thông tin liên lạc giữa Aisha và Basma và có thể sửa các gói tin. Nghĩa là, trong mỗi gói tin Cleopatra có thể sửa các bit tại đúng \(15\) vị trí. Cụ thể, có một mảng \(C\) có độ dài \(31\), trong đó mỗi phần tử đều là \(0\) hoặc \(1\), với ý nghĩa sau:
Mảng \(C\) chứa chính xác \(15\) số 1 và \(16\) số 0. Trong khi gửi thông điệp \(M\), tập hợp các chỉ số do Cleopatra kiểm soát vẫn giữ nguyên cho tất cả các gói tin. Aisha biết chính xác \(15\) chỉ số nào do Cleopatra kiểm soát. Basma chỉ biết rằng có \(15\) chỉ số do Cleopatra kiểm soát, nhưng cô ấy không biết là những chỉ số nào.
Giả sử \(A\) là một gói tin mà Aisha quyết định gửi (ta gọi là gói tin gốc). Giả sử \(B\) là gói tin mà Basma nhận được (ta gọi là gói tin bị sửa). Đối với mỗi \(i\), mà \(0 \leq i < 31\):
Ngay sau khi gửi mỗi gói tin, Aisha sẽ biết được gói tin bị sửa tương ứng là gì.
Sau khi Aisha gửi tất cả các gói tin, Basma nhận được tất cả các gói tin bị sửa theo thứ tự gửi và phải tái tạo lại thông điệp gốc \(M\).
Nhiệm vụ của bạn là thiết kế và cài đặt một chiến lược cho phép Aisha gửi thông điệp \(M\) đến Basma, để Basma có thể khôi phục \(M\) từ các gói tin đã bị sửa. Cụ thể, bạn cần cài đặt hai hàm. Hàm đầu tiên thực hiện các hành động của Aisha. Hàm được truyền vào một thông điệp \(M\) và mảng \(C\), và phải gửi một số gói tin để chuyển thông điệp đến Basma. Hàm thứ hai thực hiện các hành động của Basma. Hàm được truyền vào các gói tin đã bị sửa và phải khôi phục thông điệp gốc \(M\).
Hàm đầu tiên bạn cần cài đặt là:
void send_message(std::vector<bool> M, std::vector<bool> C)
Hàm này sẽ gọi đến hàm sau để gửi một gói tin:
std::vector<bool> send_packet(std::vector<bool> A)
send_message.Hàm thứ hai bạn cần cài đặt là:
std::vector<bool> receive_message(std::vector<std::vector<bool>> R)
send_message và được đưa ra theo thứ tự gửi bởi Aisha. Mỗi phần tử của \(R\) là một mảng có độ dài \(31\), biểu diễn một gói tin bị sửa.send_message tương ứng. Thứ tự của các lệnh gọi hàm receive_message không nhất thiết phải giống với thứ tự của các lệnh gọi send_message tương ứng.Lưu ý rằng trong hệ thống chấm điểm, các thủ tục send_message và receive_message được gọi trong hai chương trình riêng biệt.
Nếu trong bất kỳ trường hợp test nào, các lệnh gọi đến hàm send_packet không tuân thủ các quy tắc được đề cập ở trên, hoặc giá trị trả về của bất kỳ lệnh gọi nào đến hàm receive_message là không chính xác, thì điểm cho lời giải của bạn đối với trường hợp test đó sẽ là \(0\).
Trái lại, gọi \(Q\) là số lượng lời gọi tối đa đến hàm send_packet trong số tất cả các lần gọi send_message trên tất cả các trường hợp test. Ngoài ra, đặt \(X\) bằng:
Tiếp theo, điểm được tính như sau:
| Subtask | Điểm | Ràng buộc thêm |
|---|---|---|
| 1 | \(10 \cdot X\) | \(S \leq 64\) |
| 2 | \(90 \cdot X\) | Không có ràng buộc gì thêm. |
Lưu ý rằng trong một số trường hợp, hành vi của trình chấm điểm có thể là thích ứng. Điều này có nghĩa là các giá trị trả về bởi hàm send_packet có thể phụ thuộc vào không chỉ các tham số đầu vào của nó mà còn vào nhiều thứ khác, bao gồm các đầu vào và giá trị trả về của các lệnh gọi trước đó đến hàm này và các số giả ngẫu nhiên do trình chấm tạo ra. Trình chấm có tính xác định theo nghĩa là nếu bạn chạy nó hai lần và trong cả hai lần chạy, bạn gửi cùng một gói tin, nó sẽ thực hiện cùng một thay đổi đối với các gói tin đó.
Xét lời gọi sau.
send_message([0, 1, 1, 0],
[0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0,
1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1])
Thông điệp mà Aisha cố gắng gửi tới Basma là \([0, 1, 1, 0]\) . Các bit có chỉ số từ \(0\) đến \(15\) không thể bị Cleopatra thay đổi, trong khi các bit có chỉ số từ \(16\) đến \(30\) có thể được Cleopatra thay đổi.
Đối với ví dụ này, giả sử rằng Cleopatra sửa các bit liên tiếp mà cô ấy kiểm soát bằng cách điền xen kẽ \(0\) và \(1\), tức là cô ấy gán \(0\) đến chỉ số đầu tiên mà cô ấy kiểm soát (chỉ số \(16\) trong trường hợp của chúng ta), \(1\) tới chỉ số thứ hai mà cô ấy kiểm soát (chỉ số \(17\) ), \(0\) đến chỉ số thứ ba mà cô ấy kiểm soát (chỉ số \(18\) ), v.v.
Aisha có thể quyết định gửi hai bit từ thông điệp gốc trong một gói tin như sau: cô ấy sẽ gửi bit đầu tiên tại \(8\) chỉ số đầu tiên do cô ấy kiểm soát và bit thứ hai ở \(8\) chỉ số tiếp theo do cô ấy kiểm soát.
Sau đó Aisha chọn gửi gói tin sau:
send_packet([0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0])
Lưu ý rằng Cleopatra có thể thay đổi các bit với \(15\) chỉ số cuối cùng, vì vậy Aisha có thể thiết lập chúng một cách tùy ý vì chúng có thể bị ghi đè. Với chiến lược giả định của Cleopatra, hàm trả về: \([0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0]\).
Aisha quyết định gửi hai bit cuối cùng của \(M\) trong gói tin thứ hai theo cách tương tự như trên:
send_packet([1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0,
0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0])
Với chiến lược giả định của Cleopatra, hàm trả về: \([1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0]\).
Aisha có thể gửi nhiều gói tin nữa nhưng cô ta quyết định thôi.
Trình chấm tiếp theo gọi hàm sau:
receive_message([[0, 0, 0, 0, 0, 0, 0, 0, 1, 1, 1, 1, 1, 1, 1, 1,
0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0],
[1, 1, 1, 1, 1, 1, 1, 1, 0, 0, 0, 0, 0, 0, 0, 0,
0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0, 1, 0]])
Basma khôi phục thông điệp \(M\) như sau. Từ mỗi gói tin, cô ấy lấy bit đầu tiên xuất hiện hai lần liên tiếp, và bit cuối cùng xuất hiện hai lần liên tiếp. Nghĩa là, từ gói tin đầu tiên, cô ấy lấy các bit \([0, 1]\) và từ gói tin thứ hai cô ấy lấy các bit \([1, 0]\) . Bằng cách ghép chúng lại với nhau, cô ấy khôi phục được thông điệp \([0, 1, 1, 0]\), đây là giá trị trả về chính xác cho lệnh gọi receive_message này.
Có thể chứng minh rằng với chiến lược giả định của Cleopatra và đối với các thông điệp có độ dài \(4\), cách tiếp cận này của Basma khôi phục chính xác \(M\), bất kể giá trị nào của \(C\). Tuy nhiên, điều này không đúng trong trường hợp tổng quát.
Trình chấm mẫu là không thích ứng. Thay vào đó, Cleopatra điền các bit liên tiếp mà cô ấy kiểm soát bằng các bit \(0\) và \(1\) xen kẽ nhau, như mô tả trong ví dụ trên.
Định dạng dữ liệu vào: Dòng đầu tiên của đầu vào chứa một số nguyên \(T\), là số lượng kịch bản. Tiếp theo là \(T\) kịch bản. Mỗi kịch bản được cung cấp theo định dạng sau:
S
M[0] M[1] ... M[S-1]
C[0] C[1] ... C[30]
Định dạng kết quả ra: Trình chấm mẫu viết kết quả của mỗi kịch bản trong số \(T\) kịch bản theo cùng thứ tự như được cung cấp trong phần đầu vào theo định dạng sau:
K L
D[0] D[1] ... D[L-1]
Ở đây, \(K\) là số lượng lần gọi tới send_packet, \(D\) là thông điệp trả về bởi receive_message và \(L\) là độ dài thông điệp.
Nguồn: Olympic Tin học Quốc tế (IOI) 2024. Bản dịch tiếng Việt chính thức do ban tổ chức cung cấp.
Xét một cây gồm \(N\) đỉnh, các đỉnh được đánh số từ \(0\) đến \(N-1\). Đỉnh \(0\) được gọi là gốc. Mỗi đỉnh, ngoại trừ gốc, có một đỉnh cha duy nhất. Với mọi \(i\), thỏa mãn \(1 \leq i < N\), cha của đỉnh \(i\) là đỉnh \(P[i]\), trong đó \(P[i] < i\). Giả sử \(P[0] = -1\).
Với đỉnh \(i\) (\(0 \leq i < N\)) bất kì, cây con của \(i\) là tập hợp các đỉnh sau:
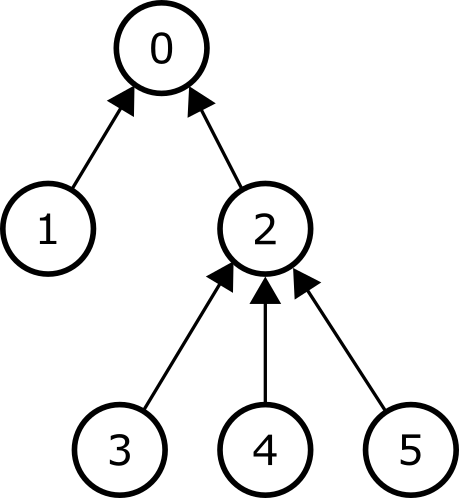
Hình bên dưới là ví dụ một cây gồm \(N = 6\) đỉnh. Mỗi mũi tên nối một đỉnh với đỉnh cha của nó, ngoại trừ gốc không có đỉnh cha. Cây con của đỉnh \(2\) chứa các đỉnh \(2, 3, 4\) và \(5\). Cây con của đỉnh \(0\) chứa tất cả \(6\) đỉnh của cây và cây con của đỉnh \(4\) chỉ chứa đỉnh \(4\).
Mỗi đỉnh được gán một trọng số nguyên không âm. Kí hiệu trọng số của đỉnh \(i\) (\(0 \leq i < N\)) là \(W[i]\).
Nhiệm vụ của bạn là viết một chương trình trả lời \(Q\) truy vấn, mỗi truy vấn được mô tả bởi một cặp số nguyên dương \((L, R)\). Câu trả lời cho truy vấn sẽ được tính như sau.
Xét việc gán một số nguyên (gọi là hệ số) cho mỗi đỉnh của cây. Một phép gán như vậy được mô tả bằng một dãy \(C[0], \ldots, C[N-1]\), trong đó \(C[i]\) (\(0 \leq i < N\)) là hệ số được gán cho đỉnh \(i\). Ta gọi dãy này là dãy hệ số. Chú ý rằng các phần tử của dãy hệ số có thể là số âm, \(0\) hoặc số dương.
Với truy vấn \((L, R)\), một dãy hệ số được gọi là hợp lệ nếu, đối với mỗi đỉnh \(i\) (\(0 \leq i < N\)), thỏa mãn điều kiện sau: tổng hệ số của các đỉnh trong cây con của đỉnh \(i\) không nhỏ hơn \(L\) và không lớn hơn \(R\).
Với một dãy hệ số xác định \(C[0], \ldots, C[N-1]\), chi phí của một đỉnh \(i\) là \(|C[i]| \cdot W[i]\), trong đó \(|C[i]|\) là giá trị tuyệt đối của \(C[i]\). Khi đó, tổng chi phí là tổng các chi phí của tất cả các đỉnh. Nhiệm vụ của bạn là đối với mỗi truy vấn tính tổng chi phí nhỏ nhất có thể đạt được bằng một dãy hệ số hợp lệ nào đó.
Có thể chứng minh được rằng đối với bất kì truy vấn nào, luôn tồn tại ít nhất một dãy hệ số hợp lệ.
Bạn cần cài đặt hai hàm sau:
void init(std::vector<int> P, std::vector<int> W)
long long query(int L, int R)
init trong mỗi trường hợp test.| Subtask | Điểm | Các ràng buộc thêm |
|---|---|---|
| 1 | \(10\) | \(Q \leq 10\); \(W[P[i]] \leq W[i]\) với mỗi \(i\) thỏa mãn \(1 \leq i < N\) |
| 2 | \(13\) | \(Q \leq 10\); \(N \leq 2\,000\) |
| 3 | \(18\) | \(Q \leq 10\); \(N \leq 60\,000\) |
| 4 | \(7\) | \(W[i] = 1\) với mỗi \(i\) thỏa mãn \(0 \leq i < N\) |
| 5 | \(11\) | \(W[i] \leq 1\) với mỗi \(i\) thỏa mãn \(0 \leq i < N\) |
| 6 | \(22\) | \(L = 1\) |
| 7 | \(19\) | Không có ràng buộc nào thêm. |
Xét các lời gọi hàm sau:
init([-1, 0, 0], [1, 1, 1])
Cây bao gồm \(3\) đỉnh, gốc và \(2\) con của nó. Mọi đỉnh đều có trọng số \(1\) .
query(1, 1)
Trong truy vấn này \(L = R = 1\) , điều này có nghĩa là tổng các hệ số trong mỗi cây con phải bằng \(1\). Xét dãy hệ số \([-1, 1, 1]\) . Cây và các hệ số tương ứng (trong hình chữ nhật tô đậm) được minh họa bên dưới.
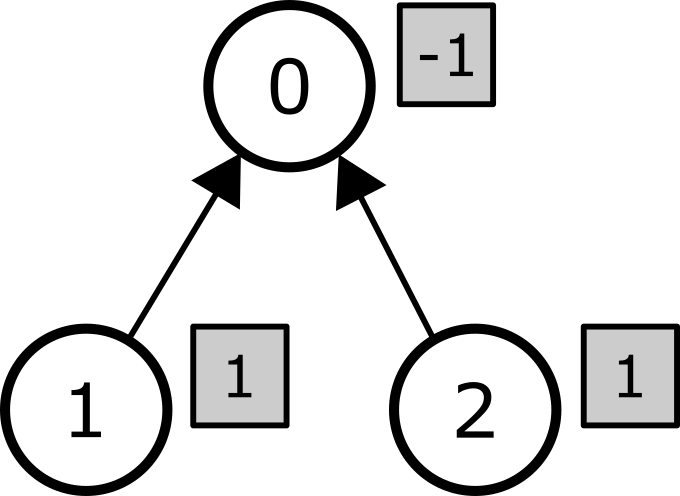
Đối với mỗi đỉnh \(i\) (\(0 \leq i < 3\)), tổng các hệ số của tất cả các đỉnh trong cây con của \(i\) bằng \(1\). Do đó, dãy hệ số này là hợp lệ. Tổng chi phí được tính như sau:
| Đỉnh | Trọng số | Hệ số | Chi phí |
|---|---|---|---|
| 0 | 1 | -1 | \(\mid -1 \mid \cdot 1 = 1\) |
| 1 | 1 | 1 | \(\mid 1 \mid \cdot 1 = 1\) |
| 2 | 1 | 1 | \(\mid 1 \mid \cdot 1 = 1\) |
Do đó tổng chi phí là \(3\). Đây là dãy hệ số hợp lệ duy nhất, do đó lệnh gọi này sẽ trả về \(3\).
query(1, 2)
Tổng chi phí nhỏ nhất cho truy vấn này là \(2\), và đạt được khi dãy hệ số là \([0, 1, 1]\).
Định dạng dữ liệu vào:
N
P[1] P[2] ... P[N-1]
W[0] W[1] ... W[N-2] W[N-1]
Q
L[0] R[0]
L[1] R[1]
...
L[Q-1] R[Q-1]
trong đó \(L[j]\) và \(R[j]\) (đối với \(0 \leq j < Q\)) là các tham số đầu vào trong lệnh gọi hàm query thứ \(j\). Chú ý rằng dòng thứ hai của dữ liệu vào chỉ chứa \(N-1\) số nguyên, vì trình chấm mẫu không đọc giá trị của \(P[0]\).
Định dạng kết quả ra:
A[0]
A[1]
...
A[Q-1]
trong đó \(A[j]\) (với \(0 \leq j < Q\)) là giá trị trả về khi gọi hàm query thứ \(j\).
Nguồn: Olympic Tin học Quốc tế (IOI) 2024. Bản dịch tiếng Việt chính thức do ban tổ chức cung cấp.