IOI 2020 - Ngày 2

Bộ đề bài

# Bài tập Điểm Thời gian: Giới hạn bộ nhớ
1 IOI 2020 - Packing Biscuits 100 (p) 1.0s 2G
2 IOI 2020 - Counting Mushrooms 100 (p) 2.0s 1G
3 IOI 2020 - Stations 100 (p) 1.0s 2G

1. IOI 2020 - Packing Biscuits

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 2G Input: bàn phím Output: màn hình

Cô Khong đang tổ chức một cuộc thi với \(x\) người tham gia và muốn tặng mỗi người một túi bánh quy. Có \(k\) loại bánh quy khác nhau, được đánh số từ \(0\) đến \(k-1\). Mỗi chiếc bánh quy loại \(i\) (\(0 \le i \le k-1\)) có độ ngon bằng \(2^i\). Trong tủ thức ăn, cô Khong có \(a[i]\) chiếc bánh quy loại \(i\); số lượng này có thể bằng không.

Mỗi túi có thể chứa không hoặc nhiều chiếc bánh quy của mỗi loại. Tổng số bánh quy loại \(i\) trong tất cả các túi không được vượt quá \(a[i]\). Tổng độ ngon của tất cả bánh quy trong một túi được gọi là tổng độ ngon của túi đó.

Hãy giúp cô Khong tìm số lượng giá trị \(y\) khác nhau sao cho có thể đóng gói \(x\) túi bánh quy, mỗi túi có tổng độ ngon bằng \(y\).

Chi tiết cài đặt

Bạn cần cài đặt hàm C++ sau:

C++
long long count_tastiness(long long x, std::vector<long long> a);
  • \(x\): số túi bánh quy cần đóng gói.
  • \(a\): mảng có độ dài \(k\). Với mỗi \(0 \le i \le k-1\), \(a[i]\) là số chiếc bánh quy loại \(i\) trong tủ thức ăn.
  • Hàm phải trả về số lượng giá trị \(y\) khác nhau sao cho cô Khong có thể đóng gói \(x\) túi bánh quy, mỗi túi có tổng độ ngon bằng \(y\).
  • Hàm được gọi tổng cộng \(q\) lần; các giá trị cho phép của \(q\) được nêu trong phần Ràng buộc và Phân nhóm. Mỗi lần gọi phải được xử lý như một kịch bản riêng biệt.

Ràng buộc

  • \(1 \le k \le 60\).
  • \(1 \le q \le 1000\).
  • \(1 \le x \le 10^{18}\).
  • \(0 \le a[i] \le 10^{18}\) (\(0 \le i \le k-1\)).

Với mỗi lần gọi count_tastiness, tổng độ ngon của tất cả bánh quy trong tủ thức ăn không vượt quá \(10^{18}\):

\[ \sum_{i=0}^{k-1} a[i]\,2^i \le 10^{18}. \]

Phân nhóm

Subtask Điểm Ràng buộc bổ sung
1 9 \(q \le 10\); với mỗi lần gọi count_tastiness, tổng độ ngon của tất cả bánh quy trong tủ thức ăn không vượt quá \(100\,000\).
2 12 \(x=1\), \(q \le 10\).
3 21 \(x \le 10\,000\), \(q \le 10\).
4 35 Giá trị trả về đúng của mỗi lần gọi count_tastiness không vượt quá \(200\,000\).
5 23 Không có ràng buộc bổ sung.

Ví dụ

Các ví dụ dưới đây mô tả lời gọi hàm và giá trị trả về.

Ví dụ 1

Input
count_tastiness(3, [5, 2, 1])
Output
5
Note

Cô Khong muốn đóng gói \(3\) túi và có \(3\) loại bánh quy trong tủ thức ăn:

  • \(5\) chiếc bánh quy loại \(0\), mỗi chiếc có độ ngon \(1\);
  • \(2\) chiếc bánh quy loại \(1\), mỗi chiếc có độ ngon \(2\);
  • \(1\) chiếc bánh quy loại \(2\), có độ ngon \(4\).

Các giá trị có thể có của \(y\) là:

\[ [0,1,2,3,4]. \]
    Chẳng hạn, để đóng gói $3$ túi, mỗi túi có tổng độ ngon $3$, cô có thể đóng gói:


    - một túi chứa ba chiếc bánh quy loại $0$;
    - hai túi, mỗi túi chứa một chiếc bánh quy loại $0$ và một chiếc bánh quy loại $1$.

    Vì có $5$ giá trị $y$ có thể có, hàm phải trả về $5$.

    ![Hình minh họa ví dụ Packing Biscuits](https://cdn.lqdoj.edu.vn/media/pagedown-uploads/pd_1_b744a53e.png)

Ví dụ 2

Input
count_tastiness(2, [2, 1, 2])
Output
6
Note

Cô Khong muốn đóng gói \(2\) túi và có \(3\) loại bánh quy trong tủ thức ăn:

  • \(2\) chiếc bánh quy loại \(0\), mỗi chiếc có độ ngon \(1\);
  • \(1\) chiếc bánh quy loại \(1\), có độ ngon \(2\);
  • \(2\) chiếc bánh quy loại \(2\), mỗi chiếc có độ ngon \(4\).

Các giá trị có thể có của \(y\) là:

\[ [0,1,2,4,5,6]. \]
    Vì có $6$ giá trị $y$ có thể có, hàm phải trả về $6$.

Dữ liệu vào

Trình chấm mẫu đọc dòng đầu tiên chứa số nguyên \(q\). Sau đó là \(q\) cặp dòng, mỗi cặp mô tả một kịch bản theo định dạng:

k x
a[0] a[1] ... a[k-1]

Dữ liệu ra

Trình chấm mẫu in \(q\) dòng. Dòng \(i\) (\(1 \le i \le q\)) chứa giá trị trả về của count_tastiness cho kịch bản thứ \(i\) trong dữ liệu vào.

Nguồn

IOI 2020, Ngày 2 — Packing Biscuits (biscuits). Đề chính thức tiếng Anh và bản dịch tiếng Việt.

2. IOI 2020 - Counting Mushrooms

Điểm: 100 (p) Thời gian: 2.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Andrew là một chuyên gia về nấm đang nghiên cứu các loài nấm bản địa của Singapore.

Trong quá trình nghiên cứu, Andrew đã thu thập \(n\) cây nấm, được gán nhãn từ \(0\) đến \(n-1\). Mỗi cây nấm thuộc một trong hai loài, được gọi là A và B.

Andrew biết rằng cây nấm \(0\) thuộc loài A, nhưng vì hai loài trông giống nhau nên anh không biết loài của các cây nấm từ \(1\) đến \(n-1\).

May mắn thay, Andrew có một chiếc máy trong phòng thí nghiệm có thể giúp anh. Để sử dụng máy, cần đặt ít nhất hai cây nấm thành một hàng bên trong máy, theo thứ tự bất kỳ, rồi bật máy. Máy sẽ tính số cặp nấm liền kề khác loài. Chẳng hạn, nếu đặt các cây nấm thuộc các loài \([A,B,B,A]\) theo đúng thứ tự này vào máy, kết quả sẽ là \(2\).

Tuy nhiên, vận hành máy rất tốn kém nên số lần sử dụng máy bị giới hạn. Ngoài ra, tổng số cây nấm được đặt vào máy qua tất cả các lần sử dụng không được vượt quá \(100\,000\). Hãy sử dụng máy để giúp Andrew đếm số cây nấm loài A đã thu thập.

Chi tiết cài đặt

Bạn cần cài đặt hàm C++ sau:

C++
int count_mushrooms(int n);
  • \(n\): số cây nấm Andrew đã thu thập.
  • Hàm được gọi đúng một lần và phải trả về số cây nấm thuộc loài A.

Trong hàm này, bạn có thể gọi hàm do trình chấm cung cấp:

C++
int use_machine(std::vector<int> x);
  • \(x\): mảng có độ dài từ \(2\) đến \(n\), tính cả hai đầu mút, mô tả nhãn các cây nấm được đặt vào máy theo đúng thứ tự.
  • Các phần tử của \(x\) phải là các số nguyên đôi một khác nhau, từ \(0\) đến \(n-1\), tính cả hai đầu mút.
  • Gọi \(d\) là độ dài của \(x\). Hàm trả về số chỉ số \(j\) thỏa mãn \(0 \le j \le d-2\) mà hai cây nấm \(x[j]\)\(x[j+1]\) thuộc hai loài khác nhau.
  • Hàm use_machine được gọi nhiều nhất \(20\,000\) lần.
  • Tổng độ dài các mảng \(x\) truyền vào use_machine qua tất cả các lần gọi không được vượt quá \(100\,000\).

Trong một số test, trình chấm hoạt động thích nghi: trình chấm không có một dãy loài nấm cố định sẵn. Thay vào đó, câu trả lời có thể phụ thuộc vào các lời gọi use_machine trước đó. Tuy nhiên, sau mỗi lần tương tác, luôn tồn tại ít nhất một dãy loài nấm phù hợp với tất cả các câu trả lời đã đưa ra tính đến thời điểm đó.

Ràng buộc

\[ 2 \le n \le 20\,000. \]

Phân nhóm

Nếu trong bất kỳ test nào, các lời gọi use_machine không tuân thủ những quy tắc ở trên, hoặc giá trị trả về của count_mushrooms không đúng, điểm của bài làm sẽ là \(0\).

Ngược lại, gọi \(Q\) là số lần gọi use_machine lớn nhất trong số tất cả các test. Điểm được tính theo bảng sau:

Điều kiện Điểm
\(20\,000 < Q\) \(0\)
\(10\,010 < Q \le 20\,000\) \(10\)
\(904 < Q \le 10\,010\) \(25\)
\(226 < Q \le 904\) \(\dfrac{226}{Q}\cdot 100\)
\(Q \le 226\) \(100\)

Ví dụ

Các ví dụ dưới đây mô tả lời gọi hàm, giá trị trả về và một chuỗi tương tác có thể thực hiện.

Ví dụ 1

Input
count_mushrooms(3)
Output
1
Note

Xét một kịch bản có \(3\) cây nấm lần lượt thuộc các loài \([A,B,B]\).

Hàm có thể gọi use_machine([0, 1, 2]), nhận được giá trị \(1\) trong kịch bản này. Sau đó, hàm có thể gọi use_machine([2, 1]), nhận được giá trị \(0\).

Lúc này đã có đủ thông tin để kết luận rằng chỉ có \(1\) cây nấm loài A. Vì vậy, count_mushrooms phải trả về \(1\).

Ví dụ 2

Input
count_mushrooms(4)
Output
3
Note

Xét một kịch bản có \(4\) cây nấm lần lượt thuộc các loài \([A,B,A,A]\).

Hàm có thể gọi use_machine([0, 2, 1, 3]), nhận được giá trị \(2\). Sau đó, hàm có thể gọi use_machine([1, 2]), nhận được giá trị \(1\).

Lúc này đã có đủ thông tin để kết luận rằng có \(3\) cây nấm loài A. Vì vậy, count_mushrooms phải trả về \(3\).

Dữ liệu vào

Trình chấm mẫu đọc mảng số nguyên \(s\) mô tả loài nấm. Với mọi \(0 \le i \le n-1\), \(s[i]=0\) nghĩa là cây nấm \(i\) thuộc loài A, còn \(s[i]=1\) nghĩa là cây nấm \(i\) thuộc loài B.

Dữ liệu vào có hai dòng theo định dạng:

n
s[0] s[1] ... s[n-1]

Trình chấm mẫu không hoạt động thích nghi.

Dữ liệu ra

Trình chấm mẫu in:

  • Dòng \(1\): giá trị trả về của count_mushrooms.
  • Dòng \(2\): số lần gọi use_machine.

Nguồn

IOI 2020, Ngày 2 — Counting Mushrooms (mushrooms). Đề chính thức tiếng Anh và bản dịch tiếng Việt.

3. IOI 2020 - Stations

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 2G Input: bàn phím Output: màn hình

Mạng trục Internet của Singapore (SIB) gồm \(n\) trạm, được đánh chỉ số từ \(0\) đến \(n-1\). Có \(n-1\) đường truyền hai chiều, được đánh số từ \(0\) đến \(n-2\). Mỗi đường truyền nối hai trạm phân biệt. Hai trạm được nối với nhau bởi một đường truyền được gọi là kề nhau.

Một đường đi từ trạm \(x\) đến trạm \(y\) là một dãy các trạm phân biệt \(a_0,a_1,\ldots,a_p\), trong đó \(a_0=x\), \(a_p=y\) và mỗi cặp trạm liên tiếp trong dãy kề nhau. Có đúng một đường đi từ bất kỳ trạm \(x\) nào đến bất kỳ trạm \(y\) nào khác.

Bất kỳ trạm \(x\) nào cũng có thể tạo một gói tin (một phần dữ liệu) và gửi đến một trạm \(y\) khác, gọi là trạm đích của gói tin. Gói tin phải được định tuyến theo đường đi duy nhất từ \(x\) đến \(y\) như sau. Xét trạm \(z\) hiện đang giữ một gói tin có trạm đích là \(y\), với \(z \ne y\). Trạm \(z\) sẽ:

  1. Thực thi một hàm định tuyến để xác định trạm kề với \(z\) nằm trên đường đi duy nhất từ \(z\) đến \(y\).
  2. Chuyển tiếp gói tin đến trạm kề đó.

Tuy nhiên, các trạm có bộ nhớ hạn chế và không lưu toàn bộ danh sách đường truyền của SIB để dùng trong hàm định tuyến.

Nhiệm vụ của bạn là cài đặt một phương thức định tuyến cho SIB, gồm hai hàm. Hàm thứ nhất nhận \(n\), danh sách đường truyền trong SIB và một số nguyên \(k \ge n-1\). Hàm này gán cho mỗi trạm một nhãn nguyên riêng biệt từ \(0\) đến \(k\), tính cả hai đầu mút.

Hàm thứ hai là hàm định tuyến, được triển khai ở tất cả các trạm sau khi gán nhãn. Hàm này chỉ nhận các dữ liệu sau:

  • \(s\): nhãn của trạm đang giữ gói tin;
  • \(t\): nhãn của trạm đích, với \(t \ne s\);
  • \(c\): danh sách nhãn của tất cả các trạm kề với trạm có nhãn \(s\).

Hàm phải trả về nhãn của trạm kề với trạm có nhãn \(s\) mà gói tin cần được chuyển tiếp đến.

Trong một subtask, điểm bài làm phụ thuộc vào giá trị nhãn lớn nhất được gán cho bất kỳ trạm nào; nhìn chung, giá trị này càng nhỏ càng tốt.

Chi tiết cài đặt

Bạn cần cài đặt hai hàm C++ sau:

C++
std::vector<int> label(int n, int k, std::vector<int> u, std::vector<int> v);
  • \(n\): số trạm trong SIB.
  • \(k\): giá trị nhãn lớn nhất được phép sử dụng.
  • \(u\)\(v\): hai mảng có độ dài \(n-1\) mô tả các đường truyền. Với mỗi \(0 \le i \le n-2\), đường truyền \(i\) nối hai trạm có chỉ số \(u[i]\)\(v[i]\).
  • Hàm phải trả về một mảng \(L\) có độ dài \(n\). Với mỗi \(0 \le i \le n-1\), \(L[i]\) là nhãn được gán cho trạm có chỉ số \(i\). Tất cả phần tử của \(L\) phải đôi một khác nhau và nằm trong đoạn từ \(0\) đến \(k\), tính cả hai đầu mút.
C++
int find_next_station(int s, int t, std::vector<int> c);
  • \(s\): nhãn của trạm đang giữ gói tin.
  • \(t\): nhãn của trạm đích của gói tin.
  • \(c\): mảng chứa nhãn của tất cả các trạm kề với trạm có nhãn \(s\). Mảng được sắp xếp theo thứ tự tăng dần.
  • Hàm phải trả về nhãn của trạm kề với trạm có nhãn \(s\) mà gói tin cần được chuyển tiếp đến, tức trạm kề nằm trên đường đi duy nhất đến trạm có nhãn \(t\).

Mỗi test chứa một hoặc nhiều kịch bản độc lập, tức các mô tả SIB khác nhau. Với một test gồm \(r\) kịch bản, chương trình gọi các hàm trên được chạy đúng hai lần.

Trong lần chạy thứ nhất:

  • label được gọi \(r\) lần;
  • hệ thống chấm lưu các nhãn được trả về;
  • find_next_station không được gọi.

Trong lần chạy thứ hai:

  • find_next_station có thể được gọi nhiều lần. Trong mỗi lần gọi, một kịch bản bất kỳ được chọn; các nhãn do lời gọi label cho kịch bản đó trả về được dùng làm dữ liệu vào cho find_next_station;
  • label không được gọi.

Đặc biệt, mọi thông tin lưu trong các biến tĩnh (static) hoặc biến toàn cục trong lần chạy thứ nhất đều không có sẵn để sử dụng trong find_next_station.

Ràng buộc

  • \(1 \le r \le 10\).

Với mỗi lần gọi label:

  • \(2 \le n \le 1000\).
  • \(k \ge n-1\).
  • \(0 \le u[i],v[i] \le n-1\) (\(0 \le i \le n-2\)).

Với mỗi lần gọi find_next_station, dữ liệu vào lấy từ một lời gọi label trước đó được chọn tùy ý. Xét các nhãn mà lời gọi đó đã tạo ra:

  • \(s\)\(t\) là nhãn của hai trạm khác nhau.
  • \(c\) là dãy nhãn của tất cả các trạm kề với trạm có nhãn \(s\), theo thứ tự tăng dần.

Trong mỗi test, tổng độ dài của tất cả các mảng \(c\) được truyền vào find_next_station, tính gộp tất cả các kịch bản, không vượt quá \(100\,000\).

Phân nhóm

Subtask Điểm Ràng buộc bổ sung
1 5 \(k=1000\); không trạm nào có nhiều hơn \(2\) trạm kề.
2 8 \(k=1000\); với mỗi \(0 \le i \le n-2\), đường truyền \(i\) nối trạm \(i+1\) và trạm \(\left\lfloor i/2 \right\rfloor\).
3 16 \(k=1\,000\,000\); có nhiều nhất một trạm có nhiều hơn \(2\) trạm kề.
4 10 \(n \le 8\), \(k=10^9\).
5 61 \(k=10^9\).

Ở subtask \(5\), bạn có thể nhận điểm thành phần. Gọi \(m\) là giá trị nhãn lớn nhất do label trả về trên tất cả các kịch bản. Điểm cho subtask này được tính theo bảng sau:

Giá trị nhãn lớn nhất Điểm
\(m \ge 10^9\) \(0\)
\(2000 \le m < 10^9\) \(50\cdot\log_{5\cdot 10^5}\!\left(\dfrac{10^9}{m}\right)\)
\(1000 < m < 2000\) \(50\)
\(m \le 1000\) \(61\)

Ví dụ

Ví dụ dưới đây mô tả các lời gọi hàm và giá trị trả về tương ứng.

Ví dụ 1

Input
label(5, 10, [0, 1, 1, 2], [1, 2, 3, 4])
find_next_station(9, 6, [2, 7])
find_next_station(2, 3, [3, 6, 9])
Output
[6, 2, 9, 3, 7]
2
3
Note

Xét lời gọi label(5, 10, [0, 1, 1, 2], [1, 2, 3, 4]). Có tổng cộng \(5\) trạm và \(4\) đường truyền nối các cặp trạm có chỉ số \((0,1)\), \((1,2)\), \((1,3)\)\((2,4)\). Mỗi nhãn có thể là một số nguyên từ \(0\) đến \(k=10\).

Để đưa ra cách gán nhãn sau:

Chỉ số Nhãn
0 6
1 2
2 9
3 3
4 7

hàm label phải trả về [6, 2, 9, 3, 7]. Các số trong hình sau thể hiện chỉ số của các trạm ở hình bên trái và nhãn được gán ở hình bên phải.
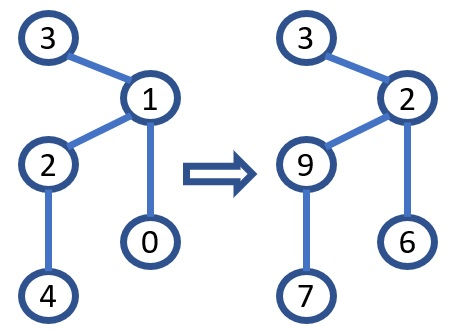
Giả sử các nhãn đã được gán như trên. Xét lời gọi:

find_next_station(9, 6, [2, 7])

Trạm đang giữ gói tin có nhãn \(9\), còn trạm đích có nhãn \(6\). Nhãn của các trạm trên đường đi đến trạm đích lần lượt là:

\[ [9,2,6]. \]
    Do đó, lời gọi phải trả về $2$, là nhãn của trạm mà gói tin cần được chuyển tiếp đến; trạm này có chỉ số $1$.

    Xét một lời gọi khác có thể xảy ra:

    ```sample
    find_next_station(2, 3, [3, 6, 9])
    ```

    Hàm phải trả về $3$, vì trạm đích có nhãn $3$ kề với trạm có nhãn $2$, nên phải nhận gói tin trực tiếp.

Dữ liệu vào

Trình chấm mẫu đọc dòng đầu chứa \(r\). Tiếp theo là \(r\) khối, mỗi khối mô tả một kịch bản theo định dạng sau; số dòng dưới đây được tính từ đầu mỗi khối:

  • Dòng \(1\): n k.
  • Dòng \(2+i\) (\(0 \le i \le n-2\)): u[i] v[i].
  • Dòng \(1+n\): \(q\), số lần gọi find_next_station.
  • Dòng \(2+n+j\) (\(0 \le j \le q-1\)): z[j] y[j] w[j], là chỉ số các trạm liên quan đến lời gọi find_next_station thứ \(j\). Trạm \(z[j]\) đang giữ gói tin, trạm \(y[j]\) là trạm đích, và trạm \(w[j]\) là trạm mà gói tin phải được chuyển tiếp đến.

Dữ liệu ra

Trình chấm mẫu in dòng đầu chứa \(m\), giá trị nhãn lớn nhất. Tiếp theo là \(r\) khối tương ứng với các kịch bản theo thứ tự trong dữ liệu vào.

Trong mỗi khối, dòng \(1+j\) (\(0 \le j \le q-1\)) chứa chỉ số của trạm có nhãn được trả về bởi lời gọi find_next_station thứ \(j\) trong kịch bản đó.

Lưu ý rằng mỗi lần chạy trình chấm mẫu đều gọi cả labelfind_next_station.

Nguồn

IOI 2020, Ngày 2 — Stations (stations). Đề chính thức tiếng Anh và bản dịch tiếng Việt.