IOI 2006 - Ngày 1

Bộ đề bài

# Bài tập Điểm Thời gian: Giới hạn bộ nhớ
1 IOI 2006 - Deciphering the Mayan Writing 100 (p) 3.0s 32M
2 IOI 2006 - Pyramid 100 (p) 1.0s 32M
3 IOI 2006 - Forbidden Subgraph 100 (p) 10.0s 256M

1. IOI 2006 - Deciphering the Mayan Writing

Điểm: 100 (p) Thời gian: 3.0s Bộ nhớ: 32M Input: bàn phím Output: màn hình

Việc giải mã chữ viết Maya đã tỏ ra khó khăn hơn những gì các nghiên cứu ban đầu dự đoán. Sau gần hai trăm năm, người ta vẫn chỉ hiểu được rất ít về loại chữ viết này. Chỉ trong ba thập kỷ gần đây mới có những tiến bộ thực sự.

Chữ viết Maya dựa trên các hình vẽ nhỏ gọi là ký tự tượng hình, dùng để biểu diễn âm thanh. Các từ trong tiếng Maya thường được viết bằng cách ghép những ký tự tượng hình ở các vị trí khác nhau.

Một trong những khó khăn khi giải mã chữ viết Maya là xác định thứ tự đọc. Khi sắp xếp các ký tự tượng hình để tạo thành một từ, đôi khi người viết lựa chọn vị trí dựa vào quan điểm thẩm mỹ của riêng mình nhiều hơn là theo một quy tắc cụ thể. Vì vậy, dù đã biết âm thanh ứng với nhiều ký tự, các nhà khảo cổ đôi khi vẫn không chắc phải phát âm một từ được viết ra như thế nào.

Các nhà khảo cổ đang tìm một từ đặc biệt \(W\). Họ biết các ký tự tượng hình của từ này nhưng không biết tất cả những cách có thể sắp xếp chúng. Biết rằng bạn sẽ tham dự IOI 2006, họ đã nhờ bạn giúp đỡ. Họ sẽ cung cấp \(g\) ký tự tượng hình của \(W\) và một dãy \(S\) gồm tất cả các ký tự tượng hình trong những bản khắc đang được nghiên cứu, theo đúng thứ tự xuất hiện. Hãy giúp họ đếm số lần từ \(W\) có thể xuất hiện.

Cho các ký tự tượng hình của \(W\) và dãy \(S\), hãy viết chương trình đếm số đoạn gồm đúng \(g\) ký tự liên tiếp trong \(S\) là một hoán vị của các ký tự trong \(W\).

Dữ liệu vào

Đọc từ đầu vào chuẩn:

  • Dòng đầu chứa hai số nguyên cách nhau bởi một dấu cách, lần lượt là \(g\)\(|S|\).
  • Dòng thứ hai chứa \(g\) ký tự liên tiếp biểu diễn các ký tự tượng hình trong \(W\).
  • Dòng thứ ba chứa \(|S|\) ký tự liên tiếp biểu diễn các ký tự tượng hình trong những bản khắc, tạo thành dãy \(S\).

Các ký tự hợp lệ trong cả \(W\)\(S\)a đến zA đến Z. Chữ hoa và chữ thường được coi là khác nhau.

Dữ liệu ra

Ghi ra đầu ra chuẩn một dòng chứa số lần \(W\) có thể xuất hiện trong \(S\).

Ràng buộc

  • \(1 \le g \le 3\,000\), trong đó \(g\) là số ký tự tượng hình trong \(W\).
  • \(g \le |S| \le 3\,000\,000\), trong đó \(|S|\) là số ký tự tượng hình trong \(S\).

Phân nhóm

Trong một tập các bộ dữ liệu kiểm tra có tổng cộng \(50\) điểm, mỗi lần chạy đều thỏa mãn \(g \le 10\).

Ví dụ

Ví dụ 1

Input
4 11
cAda
AbrAcadAbRa
Output
2

Lưu ý cho người dùng Pascal

Theo mặc định trong FreePascal, một biến kiểu string có giới hạn độ dài là \(255\) ký tự. Để sử dụng xâu dài hơn, hãy thêm chỉ thị {$H+} ngay bên dưới dòng program ...; trong mã nguồn.

Nguồn

IOI 2006, ngày thi thứ nhất: Deciphering the Mayan Writing, bản tiếng Anh 1.3. Tác giả đề bài: Cesar Cepeda (Mexico).

2. IOI 2006 - Pyramid

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 32M Input: bàn phím Output: màn hình

Sau khi giành chiến thắng trong một trận đánh lớn, vua Jaguar muốn xây một kim tự tháp vừa làm đài tưởng niệm chiến thắng, vừa làm lăng mộ cho những người lính dũng cảm đã hy sinh. Kim tự tháp sẽ được xây ngay trên chiến trường, có đáy hình chữ nhật gồm \(a\) cột và \(b\) hàng. Bên trong kim tự tháp, ở ngang mặt đất, có một gian mộ hình chữ nhật nhỏ hơn gồm \(c\) cột và \(d\) hàng, chứa thi hài và vũ khí của những người lính đã ngã xuống.

Các kiến trúc sư của nhà vua đã khảo sát chiến trường dưới dạng một lưới gồm \(m\) cột và \(n\) hàng, đồng thời đo độ cao của từng ô bằng một số nguyên.

Cả kim tự tháp lẫn gian mộ phải phủ trọn các ô của lưới, với các cạnh song song với các cạnh của chiến trường. Độ cao của các ô bên trong gian mộ phải được giữ nguyên, còn phần địa hình thuộc đáy kim tự tháp ở bên ngoài gian mộ sẽ được san bằng bằng cách chuyển cát từ các ô cao xuống các ô thấp. Độ cao cuối cùng của nền là độ cao trung bình của tất cả các ô thuộc đáy kim tự tháp, không tính các ô của gian mộ. Các kiến trúc sư có thể đặt gian mộ ở bất kỳ vị trí nào bên trong kim tự tháp, miễn là quanh gian mộ luôn có một bức tường dày ít nhất một ô.

Hãy giúp các kiến trúc sư chọn vị trí đặt kim tự tháp trên chiến trường và vị trí đặt gian mộ bên trong kim tự tháp sao cho, với các kích thước đã cho, độ cao cuối cùng của nền lớn nhất có thể.

Dữ liệu vào

Đọc từ đầu vào chuẩn:

  • Dòng đầu chứa sáu số nguyên cách nhau bởi dấu cách, theo thứ tự \(m\), \(n\), \(a\), \(b\), \(c\), \(d\).
  • Mỗi dòng trong \(n\) dòng tiếp theo chứa \(m\) số nguyên cách nhau bởi dấu cách, là độ cao các ô trên một hàng của lưới. Dòng đầu tiên trong số này ứng với hàng trên cùng, tức hàng \(1\); dòng cuối ứng với hàng dưới cùng, tức hàng \(n\). Trên mỗi dòng, các độ cao được liệt kê theo thứ tự từ cột \(1\) đến cột \(m\).

Dữ liệu ra

Ghi ra đầu ra chuẩn hai dòng:

  • Dòng đầu chứa hai số nguyên cách nhau bởi một dấu cách, chỉ góc trên bên trái của đáy kim tự tháp: số thứ nhất là cột, số thứ hai là hàng.
  • Dòng thứ hai chứa hai số nguyên cách nhau bởi một dấu cách, chỉ góc trên bên trái của gian mộ bên trong kim tự tháp: số thứ nhất là cột, số thứ hai là hàng.

Nếu có nhiều cách bố trí tối ưu, bạn có thể đưa ra bất kỳ cách nào trong số đó.

Ràng buộc

  • \(3 \le m \le 1\,000\).
  • \(3 \le n \le 1\,000\).
  • \(3 \le a \le m\).
  • \(3 \le b \le n\).
  • \(1 \le c \le a-2\).
  • \(1 \le d \le b-2\).
  • Mọi độ cao đều là số nguyên từ \(1\) đến \(100\).

Phân nhóm

Trong một tập các bộ dữ liệu kiểm tra có tổng cộng \(30\) điểm, mỗi lần chạy đều đồng thời thỏa mãn \(3 \le m \le 10\)\(3 \le n \le 10\).

Ví dụ

Ví dụ 1

Input
8 5 5 3 2 1
1 5 10 3 7 1 2 5
6 12 4 4 3 3 1 5
2 4 3 1 6 6 19 8
1 1 1 3 4 2 4 5
6 6 3 3 3 2 2 2
Output
4 1
6 2
Note
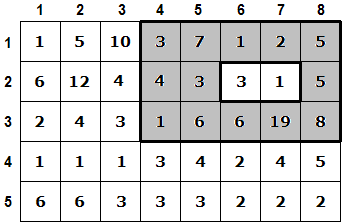
Hình vẽ minh họa chiến trường trong ví dụ. Số trong mỗi ô biểu diễn độ cao địa hình tại ô đó. Các ô màu xám biểu diễn nền kim tự tháp, còn các ô màu trắng được bao quanh bên trong biểu diễn gian mộ. Đây là một cách bố trí tối ưu.

Nguồn

IOI 2006, ngày thi thứ nhất: Pyramid, bản tiếng Anh 1.2. Tác giả đề bài: Hugo Ryckeboer (Argentina).
3. IOI 2006 - Forbidden Subgraph

Điểm: 100 (p) Thời gian: 10.0s Bộ nhớ: 256M Input: bàn phím Output: màn hình

Hai đồ thị vô hướng \(G\)\(H\) được gọi là đẳng cấu nếu chúng có cùng số đỉnh và tồn tại một tương ứng một-một giữa các đỉnh của chúng sao cho: với hai đỉnh phân biệt bất kỳ của \(G\), có một cạnh nối chúng khi và chỉ khi có một cạnh nối hai đỉnh tương ứng trong \(H\).

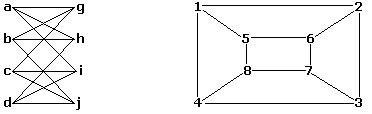
Chẳng hạn, hai đồ thị dưới đây đẳng cấu, mặc dù hình vẽ của chúng trông khác nhau:

Một tương ứng một-một chứng minh hai đồ thị này đẳng cấu là \(a \leftrightarrow 1\), \(b \leftrightarrow 6\), \(c \leftrightarrow 8\), \(d \leftrightarrow 3\), \(g \leftrightarrow 5\), \(h \leftrightarrow 2\), \(i \leftrightarrow 4\), \(j \leftrightarrow 7\). Ngoài ra còn có những tương ứng khác.

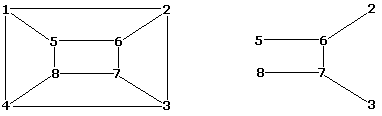
Một đồ thị con của đồ thị \(G\) là một đồ thị có tập đỉnh và tập cạnh lần lượt là các tập con của tập đỉnh và tập cạnh của \(G\). Lưu ý rằng \(G\) cũng là một đồ thị con của chính nó. Hình dưới đây minh họa một đồ thị và một trong các đồ thị con của nó:

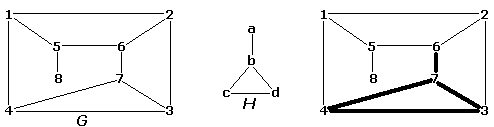
Ta nói đồ thị \(G\) chứa đồ thị \(H\) nếu có ít nhất một đồ thị con \(H'\) của \(G\) đẳng cấu với \(H\). Hình sau minh họa một đồ thị \(G\) chứa đồ thị \(H\):

Cho hai đồ thị vô hướng \(G\)\(H\), hãy tạo một đồ thị con \(G'\) của \(G\) sao cho \(G'\) có cùng số đỉnh với \(G\)không chứa \(H\). Có thể có nhiều đồ thị con thỏa mãn các điều kiện trên; hãy đưa ra một đồ thị như vậy có càng nhiều cạnh càng tốt.

Thuật toán cơ sở

Có lẽ chiến lược đơn giản nhất là xét các cạnh của \(G\) theo thứ tự chúng được biểu diễn trong tệp dữ liệu vào, rồi lần lượt thử thêm từng cạnh vào \(G'\), kiểm tra ở mỗi bước xem \(G'\) có chứa \(H\) hay không. Chỉ giữ lại cạnh nếu sau khi thêm cạnh đó, \(G'\) vẫn không chứa \(H\). Một cài đặt đúng của thuật toán tham lam này sẽ nhận được một phần điểm, nhưng còn có những chiến lược tốt hơn nhiều.

Dữ liệu vào

Đây là bài chỉ nộp kết quả. Bạn được cung cấp \(10\) tệp forbidden1.in đến forbidden10.in. Mỗi tệp forbiddenK.in có cấu trúc như sau:

  • Dòng đầu chứa hai số nguyên cách nhau bởi một dấu cách, lần lượt là \(m\)\(n\).
  • \(m\) dòng tiếp theo biểu diễn ma trận kề của \(H\). Mỗi dòng chứa \(m\) số nguyên cách nhau bởi dấu cách và tương ứng với một đỉnh của \(H\), theo thứ tự \(1,\ldots,m\). Phần tử thứ \(i\) trên dòng thứ \(j\) của phần này bằng \(1\) nếu có cạnh nối hai đỉnh \(i\)\(j\) trong \(H\), và bằng \(0\) nếu không có.
  • \(n\) dòng tiếp theo biểu diễn ma trận kề của \(G\). Mỗi dòng chứa \(n\) số nguyên cách nhau bởi dấu cách và tương ứng với một đỉnh của \(G\), theo thứ tự \(1,\ldots,n\). Phần tử thứ \(i\) trên dòng thứ \(j\) của phần này bằng \(1\) nếu có cạnh nối hai đỉnh \(i\)\(j\) trong \(G\), và bằng \(0\) nếu không có.

Như vậy, ngoại trừ dòng đầu tiên, dữ liệu vào chính là hai ma trận kề của \(H\)\(G\), theo thứ tự này.

Dữ liệu ra

Bạn phải nộp \(10\) tệp kết quả, mỗi tệp ứng với một tệp dữ liệu vào. Tệp forbiddenK.out phải có cấu trúc sau:

  • Dòng đầu là dòng tiêu đề, có dạng chính xác #FILE forbidden K, trong đó \(K\) là số từ \(1\) đến \(10\) ứng với tệp dữ liệu vào đang được giải.
  • Dòng thứ hai chứa một số nguyên \(n\).
  • \(n\) dòng tiếp theo biểu diễn ma trận kề của \(G'\). Mỗi dòng chứa \(n\) số nguyên cách nhau bởi dấu cách và tương ứng với một đỉnh của \(G'\), theo thứ tự \(1,\ldots,n\). Phần tử thứ \(i\) trên dòng thứ \(j\) của phần này bằng \(1\) nếu có cạnh nối hai đỉnh \(i\)\(j\) trong \(G'\), và bằng \(0\) nếu không có.

Như vậy, ngoại trừ hai dòng đầu, dữ liệu ra chính là ma trận kề của \(G'\).

Ràng buộc

  • \(3 \le m \le 4\), trong đó \(m\) là số đỉnh của \(H\).
  • \(3 \le n \le 1\,000\), trong đó \(n\) là số đỉnh của \(G\).

Chấm điểm

Phiên bản này sử dụng quy tắc chấm điểm cố định của LQDOJ, phỏng theo cách chuẩn hóa của bản chuyển thể trên Codeforces. Điểm không phụ thuộc vào bài nộp của người chơi khác và không tái hiện điểm lịch sử IOI 2006.

Mỗi tệp chiếm \(10\) điểm trong tổng số \(100\) điểm. Kết quả sai định dạng, thêm cạnh không có trong \(G\), thay đổi số đỉnh hoặc chứa \(H\) nhận \(0\) điểm cho tệp đó. Ma trận phải đối xứng, chỉ chứa \(0,1\) và có đường chéo bằng \(0\). Việc chứa \(H\) xét theo đồ thị con thông thường, không yêu cầu đồ thị con cảm sinh.

Với kết quả hợp lệ, gọi \(E_y\) là số cạnh giữ lại, \(E_b\) là mốc cơ sở và \(T\) là mốc đạt đủ điểm trong bảng sau. Phần trăm điểm của tệp là:

\[ p=\begin{cases} 30\dfrac{E_y}{E_b}, & E_y\le E_b,\\ \min\left(100,30+70\dfrac{E_y-E_b}{T-E_b}\right), & E_y>E_b. \end{cases} \]
Tệp \(K\) Mốc cơ sở \(E_b\) Mốc đủ điểm \(T\)
1 1 3
2 6 82
3 4 52
4 1 134
5 2 23
6 2 126
7 99 197
8 31 195
9 140 2868
10 541 12125

Các mốc \(T\) được chọn từ số cạnh của các cách xây dựng trong lời giải chính thức; riêng tệp \(7\) dùng mốc \(197\) được chứng minh từ dữ liệu công khai. Đây là các mốc của phiên bản này, không phải khẳng định mọi mốc đều tối ưu. Kết quả hợp lệ vượt \(T\) vẫn nhận đủ điểm và không làm thay đổi mốc chấm.

Trong kỳ thi này, điểm từng tệp là điểm cao nhất của tệp đó trên tất cả các lần nộp của bạn, rồi cộng các điểm này để tính tổng. Đây là quy tắc tổng hợp điểm của phiên bản chuyển thể, không phải quy tắc lịch sử IOI 2006.

Tổng điểm là tổng của \(10p/100\) trên cả \(10\) tệp. Không làm tròn điểm từng tệp về số nguyên. Đồ thị không có cạnh nhận \(0\) điểm. Nộp một tệp ZIP chứa trực tiếp forbidden1.out đến forbidden10.out, không đặt trong thư mục con. Tệp thiếu nhận \(0\) điểm; các tệp còn lại được chấm độc lập. ZIP tối đa \(10\) MiB; mỗi tệp kết quả phải nhỏ hơn \(8\) MiB, mỗi dòng ma trận tối đa \(8192\) ký tự.

Ví dụ

Ví dụ 1

Input
3 5
0 1 0
1 0 1
0 1 0
0 1 0 0 0
1 0 1 0 0
0 1 0 1 0
0 0 1 0 1
0 0 0 1 0
Output
#FILE forbidden K
5
0 1 0 0 0
1 0 0 0 0
0 0 0 0 0
0 0 0 0 0
0 0 0 0 0
Note

Ví dụ minh họa cấu trúc của forbiddenK.inforbiddenK.out; \(K\) trong dòng tiêu đề là số thứ tự tệp tương ứng, từ \(1\) đến \(10\). Có nhiều kết quả có thể đưa ra. Kết quả minh họa ở trên hợp lệ nhưng chưa tối ưu.

Nguồn

IOI 2006, ngày thi thứ nhất: Forbidden Subgraph, bản tiếng Anh 1.2. Tác giả đề bài: Francisco Zaragoza (Mexico).

10 tệp dữ liệu vào.