| # | Bài tập | Điểm | Thời gian: | Giới hạn bộ nhớ |
|---|---|---|---|---|
| 1 | Google Code Jam 2020 - Naming Compromise | 12 | 1.0s | 1G |
| 2 | Google Code Jam 2020 - Pen Testing | 100 | 3.5s | 1G |
| 3 | Google Code Jam 2020 - Recalculating | 32 | 16.0s | 1G |
| 4 | Google Code Jam 2020 - Thermometers | 24 | 1.5s | 1G |
Cameron và Jamie sắp chào đón em bé thứ hai. Họ vốn đã phối hợp ăn ý trong vai trò cha mẹ, nhưng lúc này lại bất đồng về một việc vô cùng quan trọng! Cameron muốn đặt cho em bé một cái tên (chuỗi C), còn Jamie lại muốn đặt một cái tên khác (chuỗi J).
Bạn muốn giúp họ tìm một tên thỏa hiệp gần nhất có thể với mong muốn của mỗi người. Bạn cho rằng có thể làm điều này bằng khái niệm khoảng cách chỉnh sửa. Khoảng cách chỉnh sửa giữa hai chuỗi \(S_1\) và \(S_2\) là số phép toán ít nhất cần thực hiện để biến đổi \(S_1\) thành \(S_2\), trong đó các phép toán được phép là:
Ví dụ, khoảng cách chỉnh sửa giữa CAMERON và JAMIE là 5. Một cách thực hiện phép biến đổi trong 5 bước là: CAMERON thành JAMERON (đổi), thành JAMIERON (chèn), thành JAMIEON (xóa), thành JAMIEN (xóa), rồi thành JAMIE (xóa). Mọi cách biến đổi CAMERON thành JAMIE đều cần ít nhất từng ấy phép toán.
Để tên thỏa hiệp \(N\) gần nhất có thể với mong muốn ban đầu của cha mẹ, bạn muốn \(N\) là một chuỗi không rỗng sao cho tổng khoảng cách chỉnh sửa giữa C và \(N\) với khoảng cách chỉnh sửa giữa J và \(N\) là nhỏ nhất có thể. Trong tất cả các lựa chọn \(N\) như vậy, để bảo đảm sự thỏa hiệp là công bằng, bạn phải chọn một \(N\) sao cho hiệu tuyệt đối giữa hai khoảng cách chỉnh sửa đó cũng nhỏ nhất có thể. Hãy tìm một tên thỏa hiệp cho Cameron và Jamie.
Dòng đầu tiên cho biết số lượng bộ test T. Tiếp theo là T bộ test. Mỗi bộ gồm một dòng chứa hai chuỗi C và J, lần lượt là những cái tên Cameron và Jamie đề xuất cho em bé. Mỗi tên chỉ gồm các chữ cái tiếng Anh viết hoa.
Với mỗi bộ test, in một dòng có dạng Case #x: y, trong đó x là số thứ tự bộ test (bắt đầu từ 1) và y là một cái tên đáp ứng các yêu cầu đã nêu. Lưu ý rằng y chỉ được chứa các chữ cái tiếng Anh viết hoa.
X, Y hoặc Z.X, Y hoặc Z.Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 4/12 | 33,33% |
| Test Set 2 | 8/12 | 66,67% |
Ví dụ 1
4
XYZZY ZZYZX
Y Z
YYXXYZ ZYYXXY
XZXZXZ YZ
Case #1: ZZY
Case #2: Z
Case #3: ZYYXXYZ
Case #4: ZYZX
Các trường hợp trên đáp ứng giới hạn của Test Set 1. Một trường hợp mẫu khác không đáp ứng các giới hạn đó được đưa ra ở cuối phần này.
Trong trường hợp mẫu #1, khoảng cách chỉnh sửa từ XYZZY đến ZZY là 2 (xóa hai ký tự đầu tiên), và khoảng cách chỉnh sửa từ ZZYZX đến ZZY là 2 (xóa hai ký tự cuối cùng). XZZX và ZYYZY cũng là những đáp án đúng. Không có tên nào có tổng khoảng cách chỉnh sửa nhỏ hơn 4.
Chẳng hạn, ZY có cùng khoảng cách chỉnh sửa đến C và J (đều bằng 3). Tuy nhiên, tổng các khoảng cách đó là 6, không phải giá trị nhỏ nhất, nên đây không phải một đáp án được chấp nhận.
XZZY cũng không được chấp nhận. Khoảng cách chỉnh sửa từ nó đến C và J lần lượt là 1 và 3. Tổng hai khoảng cách chỉnh sửa này là nhỏ nhất, nhưng hiệu tuyệt đối giữa chúng (\(|1-3|=2\)) không nhỏ nhất, vì ta đã chỉ ra rằng có thể đạt hiệu bằng 0.
Trong trường hợp mẫu #2, Y và Z là hai đáp án duy nhất được chấp nhận.
Trong trường hợp mẫu #3, lưu ý rằng các giới hạn về độ dài dữ liệu vào không áp dụng cho dữ liệu ra, nên đáp án đã cho được chấp nhận trong cả hai test set. Một đáp án khác có thể là YYXXY.
Trong trường hợp mẫu #4, khoảng cách chỉnh sửa giữa XZXZXZ và ZYZX là 3, còn khoảng cách chỉnh sửa giữa YZ và ZYZX là 2. Tổng hai khoảng cách chỉnh sửa đó là 5 và hiệu tuyệt đối của chúng là 1; các giá trị này là tối ưu cho trường hợp này.
Trường hợp bổ sung sau đây không thể xuất hiện trong Test Set 1, nhưng có thể xuất hiện trong Test Set 2.
1
GCJ ABC
Case #1: GC là một trong những đầu ra đúng có thể có.
Google Code Jam 2020, Vòng 3, bài Naming Compromise.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Bạn có \(N\) chiếc bút bi. Mỗi chiếc có một lượng mực nguyên phân biệt từ \(0\) đến \(N-1\), nhưng các bút được đưa theo thứ tự ngẫu nhiên nên bạn không biết chiếc nào ứng với lượng nào.
Bạn sắp đi Nam Cực (nơi không có bút), hành lý chỉ đủ chỗ cho hai chiếc, và bạn sẽ phải viết rất nhiều bưu thiếp quan trọng. Cụ thể, tổng lượng mực của hai bút được chọn phải ít nhất là \(N\) đơn vị.
Cách duy nhất để thu thập thông tin là chọn một bút và thử viết. Nếu thành công, bút mất một đơn vị mực (và có thể vừa cạn); nếu thất bại, bút vốn đã hết mực. Bạn có thể lặp lại nhiều lần với cùng bút hoặc các bút khác nhau.
Cuối cùng, bạn phải chọn hai bút mang theo và thành công nếu tổng lượng mực còn lại của chúng ít nhất là \(N\).
Bạn nhận \(T\) trường hợp kiểm thử và phải thành công trong ít nhất \(C\) trường hợp. Mọi bộ kiểm thử của bài đều có kết quả chấm hiển thị.
Nội dung vào được cung cấp theo giao thức mô tả dưới đây.
Đây là bài tương tác. Hãy chắc chắn bạn đã đọc mục Bài toán tương tác trong FAQ.
Ban đầu, đọc một dòng gồm \(T\), \(N\), \(C\): số trường hợp, số bút và số trường hợp tối thiểu phải thành công. (\(N\) giống nhau ở mọi bộ kiểm thử và chỉ được nhập để tiện sử dụng; xem mục Giới hạn.)
Sau đó phải xử lý đồng thời cả \(T\) trường hợp để giảm số lượt trao đổi với bộ chấm. Tương tác được chia thành các vòng.
Đầu mỗi vòng, in một dòng gồm \(T\) số: số thứ \(i\) là số hiệu bút muốn thử trong trường hợp \(i\), hoặc \(0\) nếu không thử bút nào ở trường hợp đó trong vòng này. Bút được đánh số từ \(1\) đến \(N\).
Xả bộ đệm sau từng số thay vì một lần sau cả \(T\) số có thể gây Quá thời gian vì chính chi phí xả bộ đệm.
Bộ chấm trả một dòng gồm \(T\) số: số thứ \(i\) là lượng mực tiêu hao ở trường hợp \(i\) trong vòng này. Nó bằng \(1\) nếu viết thành công; nếu không thì bằng \(0\), có thể vì bút đã hết mực hoặc vì bạn không thử viết.
Bạn được thực hiện nhiều nhất \(N\times(N+1)/2\) vòng; số này đủ để chắc chắn làm cạn mọi bút.
Khi sẵn sàng trả lời tất cả trường hợp, in một dòng có số \(0\) lặp \(T\) lần. Dòng này không tính vào giới hạn vòng và bộ chấm không phản hồi.
Sau đó in một dòng gồm \(2\times T\) số: số thứ \((2\times i-1)\) và \((2\times i)\) là số hiệu phân biệt của hai bút mang đi trong trường hợp \(i\). Bộ chấm không phản hồi; chương trình phải kết thúc không lỗi.
Nếu nhận đầu ra bất ngờ, bộ chấm in duy nhất \(-1\) rồi ngừng. Nếu vẫn chờ sau khi nhận \(-1\), chương trình sẽ Quá thời gian; bạn phải kết thúc kịp để nhận Sai. Vượt bộ nhớ hoặc lỗi khi chạy sẽ nhận kết quả tương ứng.
Thứ tự bút được chọn ngẫu nhiên đều và độc lập cho từng trường hợp và từng lần nộp. Ngay cả khi nộp cùng một mã hai lần, bộ chấm vẫn dùng các thứ tự khác nhau.
\(N=15\).
\(T=20000\).
\(C=10900\) (\(C=0.545\times T\)).
\(T=20000\).
\(C=12000\) (\(C=0.6\times T\)).
\(T=100000\).
\(C=63600\) (\(C=0.636\times T\)).
Chương trình phải tuân thủ đầy đủ thứ tự đọc, ghi, phản hồi lỗi và yêu cầu flush được mô tả trong phần dữ liệu vào/ra và công cụ kiểm thử bên dưới.
Bạn có thể dùng công cụ kiểm thử cục bộ hoặc trên nền tảng. Để kiểm tra cục bộ, chạy công cụ song song với mã bằng trình chạy tương tác. Xem hướng dẫn trong chú thích của tệp và mục Bài toán tương tác trong FAQ.
Hướng dẫn nằm trong chú thích của công cụ. Bạn nên tự thêm trường hợp kiểm thử. Dù mô phỏng hệ thống chấm, công cụ KHÔNG phải bộ chấm thật và có thể hành xử khác. Nếu qua công cụ nhưng trượt bộ chấm thật, hãy xem mục Lập trình trong FAQ để bảo đảm dùng cùng trình biên dịch.
Tương tác sau không thuộc ba bộ kiểm thử vì \(T,N\) quá nhỏ; nó chỉ minh họa giao thức.
Ví dụ 1
2 5 11 00 10 1
4 54 30 20 03 4 3 4
Sau đây là cùng tương tác ấy kèm diễn giải:
// Đọc 2 vào t, 5 vào n và 1 vào c.
t, n, c = readline_int_list()
// Bộ chấm bí mật chọn lượng mực của từng bút:
// trường hợp 1: 2 0 4 1 3
// trường hợp 2: 1 3 2 4 0
// Viết bằng bút 4 ở trường hợp 1 và bút 5 ở trường hợp 2.
printline 4 5 to stdout
flush stdout
// Đọc 1 0: bút 4 ở trường hợp 1 còn mực, bút 5 ở trường hợp 2 thì không.
a1, a2 = readline_int_list()
// Lại viết bằng bút 4 ở trường hợp 1 và bút 3 ở trường hợp 2.
printline 4 3 to stdout
flush stdout
// Đọc 0 1.
a1, a2 = readline_int_list()
// Lần này chỉ viết ở trường hợp 2, bằng bút 2.
printline 0 2 to stdout
flush stdout
// Đọc 0 1.
a1, a2 = readline_int_list()
// Quyết định đã sẵn sàng trả lời.
printline 0 0 to stdout
flush stdout
// Mang bút 3 và 4 đi trong cả hai trường hợp.
printline 3 4 3 4 to stdout
flush stdout
// Trường hợp 1: hai bút còn 4 và 0; 4+0<5 nên thất bại.
// Trường hợp 2: hai bút còn 1 và 4; 1+4≥5 nên thành công.
// Thành công 1/2 trường hợp, đủ vì c=1.
exit
Google Code Jam 2020, Vòng 3, bài Pen Testing.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Bạn làm việc cho bộ phận thiết kế chỉ đường dự phòng cho drone giao hàng tự lái của Apricot Rules LLC. Công ty sắp đưa drone đầu tiên, Principia, ra thị trường. Bạn phải thiết kế hệ thống dự phòng khi nó mất hệ thống định vị chính như GPS nhưng vẫn cần chỉ đường. Principia hoạt động trên một mặt phẳng Descartes có tọa độ tính bằng mét. Một hoặc nhiều điểm là trung tâm sửa chữa drone, và không có hai trung tâm cùng vị trí.
Principia thu thập được vị trí tương đối của các trung tâm cách nó không quá \(D\) mét theo khoảng cách \(L_1\) (Manhattan). Chẳng hạn: “một trung tâm cách 4 mét về bắc và 3,5 mét về tây, trung tâm khác cách 2,5 mét về đông”. Thông tin không định danh trung tâm, mà chỉ cho vị trí tương đối với Principia.
Có thể tồn tại hai hay nhiều điểm khác nhau cho cùng thông tin, khiến Principia không xác định duy nhất vị trí. Những điểm như vậy gọi là không phân biệt được; các điểm còn lại là phân biệt được.
Một cách hình thức, tại \((x,y)\),
Ở đây \(|z-x|,|w-y|\) là các giá trị tuyệt đối tương ứng. Điểm \((x_1,y_1)\) không phân biệt được khi và chỉ khi tồn tại điểm khác \((x_2,y_2)\) sao cho \(\operatorname{Info}(x_1,y_1)=\operatorname{Info}(x_2,y_2)\).
Ví dụ, với \(D=4\) và các trung tâm \((0,0),(5,0)\), điểm \((0,0)\) không phân biệt được vì \(\operatorname{Info}(0,0)=\{(0,0)\}=\operatorname{Info}(5,0)\); do đó \((5,0)\) cũng vậy. Ngược lại, \(\operatorname{Info}(3.5,0.1)=\{(-3.5,-0.1),(1.5,-0.1)\}\) không bằng thông tin ở bất kỳ điểm nào khác, nên điểm ấy phân biệt được. Hình minh họa miền phân biệt được (đỏ) và không phân biệt được (xanh):
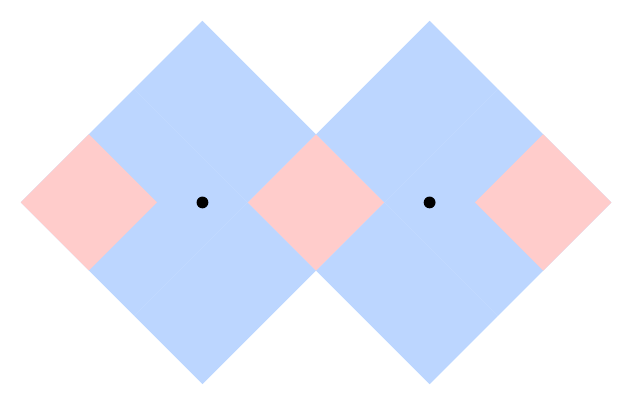
Principia được đặt tại một điểm chọn ngẫu nhiên đều trong tập mọi điểm cách ít nhất một trung tâm không quá \(D\) theo \(L_1\), tức nơi Info khác rỗng. Xác suất thuộc một tập liên tục \(S\) tỉ lệ với diện tích mét vuông của \(S\). Trong ví dụ, mỗi hình vuông đỏ rộng \(4.5\), mỗi phần xanh rộng \(23\) mét vuông. Xác suất vào mỗi hình đỏ là \(4.5/(3\times4.5+2\times23)\), vào mỗi phần xanh là \(23/(3\times4.5+2\times23)\). Biên giữa các phần khác màu có diện tích 0 nên xác suất rơi đúng lên biên bằng 0.
Cho mọi vị trí trung tâm, hãy tính xác suất vị trí triển khai Principia phân biệt được.
Dòng đầu chứa \(T\). Mỗi test bắt đầu bằng \(N,D\): số trung tâm và khoảng cách \(L_1\) tối đa để thu thập thông tin. Sau đó là \(N\) dòng; dòng \(i\) chứa tọa độ nguyên \(X_i,Y_i\) của trung tâm thứ \(i\). Mọi tọa độ và \(D\) tính bằng mét.
Với mỗi test, in Case #x: y z, trong đó x bắt đầu từ 1, y,z là số nguyên không âm và y/z biểu diễn xác suất cần tìm khi chọn đều trong mọi vị trí cách ít nhất một trung tâm không quá \(D\) theo \(L_1\). Nếu có nhiều cặp hợp lệ, chọn cặp có z nhỏ nhất.
\(N=2\).
\(2\le N\le10\).
Trong 6 test, \(N=1687\); trong \(T-6\) test còn lại, \(2\le N\le100\).
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 6/32 | 18,75% |
| Test Set 2 | 11/32 | 34,38% |
| Test Set 3 | 15/32 | 46,87% |
Ví dụ 1
Dữ liệu mẫu và phần giải thích chính thức được trình bày đầy đủ ngay bên dưới.
4
2 4
0 0
5 0
2 1
0 0
5 0
2 4
0 0
4 4
2 4
0 0
5 1
Case #1: 27 119
Case #2: 0 1
Case #3: 0 1
Case #4: 1 5
??? "Giải thích"
Các test trên thỏa Test Set 1; một test không thỏa nằm cuối phần. Test 1 đã được mô tả trong đề.
Mọi điểm ở miền đỏ giữa phân biệt được vì chỉ chúng thấy cả hai trung tâm và mỗi điểm nhận tập thông tin riêng.
Các điểm ở mỗi miền đỏ trái/phải chỉ thấy một trung tâm nhưng thông tin luôn duy nhất. Ví dụ, nếu Principia biết nó ở 3 mét phía đông một trung tâm, đó không thể là trung tâm $(0,0)$ vì khi ấy nó thấy cả hai; vậy phải là trung tâm $(5,0)$.
Mọi điểm xanh không phân biệt được: thông tin chỉ chứa trung tâm trong tầm, và có một điểm tương ứng ở miền xanh kia cho đúng cùng thông tin.
Xác suất vào mỗi phần đỏ là $4.5/59.5$, nên tổng là $3\times4.5/59.5=27/119$.
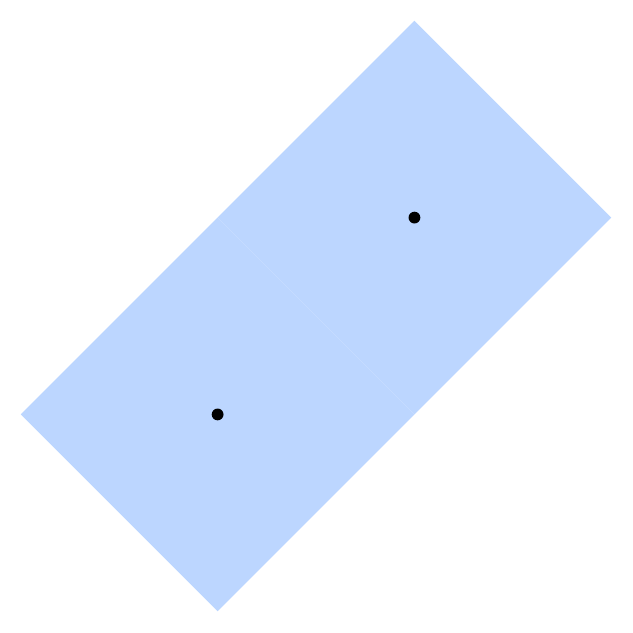
Hình sau minh họa test 2. Không nơi nào thấy hơn một trung tâm, nên mọi điểm đủ gần một trung tâm đều có điểm tương ứng gần trung tâm kia. Mẫu `z` phải tối thiểu, vì vậy chỉ `0 1` hợp lệ.
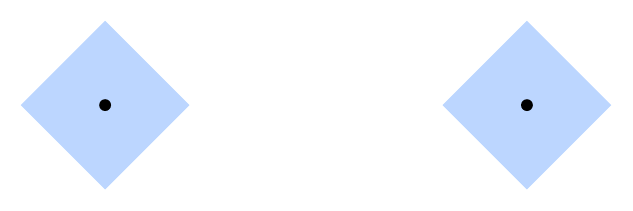
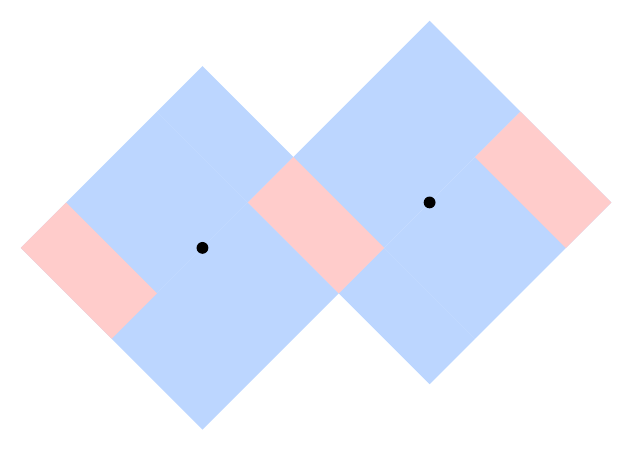
Hình sau minh họa test 3. Biên hai hình xanh gồm các điểm phân biệt được, nhưng diện tích bằng 0 nên xác suất rơi vào đó bằng 0. Mọi điểm triển khai khác đều không phân biệt được.
Hình sau minh họa test 4.
Hình sau minh họa test bổ sung.
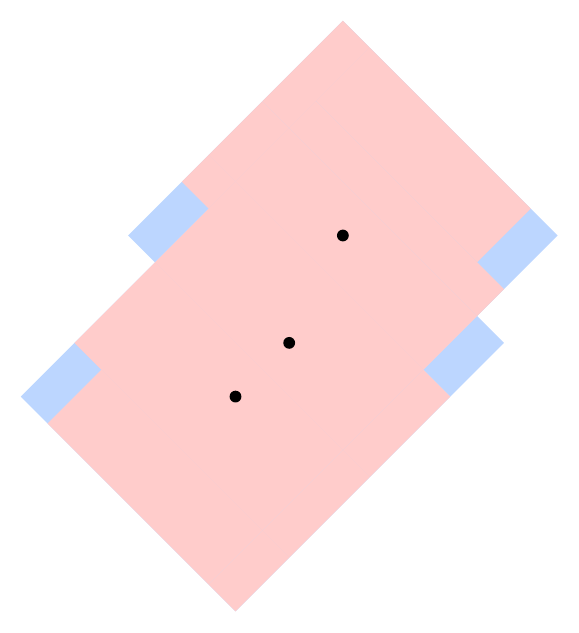
Test bổ sung này không thể có trong Test Set 1 nhưng có thể có trong các Test Set khác:
```sample
1
3 4
0 0
1 1
2 3
```
Đầu ra đúng là `Case #1: 101 109`.
Google Code Jam 2020, Vòng 3, bài Recalculating.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Bạn thuộc nhóm nghiên cứu khí hậu dọc bờ một hòn đảo. Bờ biển được mô hình hóa bằng đường tròn chu vi \(K\) ki-lô-mét. Một ngọn hải đăng chiếm đúng một điểm trên đường tròn. Mỗi điểm được ánh xạ tới số thực trong \([0,K)\); điểm \(x\) cách hải đăng \(x\) ki-lô-mét khi đi theo chiều kim đồng hồ. Ví dụ, nếu \(K=5\), điểm \(0\) là hải đăng, điểm \(1.5\) cách nó \(1.5\) ki-lô-mét theo chiều kim đồng hồ, còn điểm \(2.5\) đối diện nó qua đường kính.
Bạn phụ trách nghiên cứu nhiệt độ ven biển. Nhóm khác lắp hệ thống gồm một số nhiệt kế tại các điểm cụ thể; không có hai chiếc cùng vị trí. Điểm không có nhiệt kế được coi là mang nhiệt độ của nhiệt kế gần nhất. Nếu cách đều hai nhiệt kế, hệ thống dùng chiếc nằm theo chiều kim đồng hồ (chiếc đầu tiên gặp khi đi từ điểm ấy theo chiều kim đồng hồ).
Bạn không biết số lượng và vị trí nhiệt kế nhưng có dữ liệu gồm hai danh sách \(N\) giá trị \(X_1,\ldots,X_N\) và \(T_1,\ldots,T_N\). Với \(1\le i<N\), mọi \(x\) thỏa \(X_i\le x<X_{i+1}\) mang nhiệt độ \(T_i\); mọi \(x\) thỏa \(0\le x<X_1\) hoặc \(X_N\le x<K\) mang \(T_N\). Các điểm được liệt kê theo chiều kim đồng hồ nên \(X_i<X_{i+1}\) với mọi \(i\).
Hãy tìm số nhiệt kế nhỏ nhất có thể tạo ra dữ liệu quan sát được khi đặt tại một tập vị trí nào đó.
Dòng đầu chứa số bộ test \(T\). Mỗi bộ test gồm ba dòng. Dòng đầu chứa hai số nguyên \(K,N\): chu vi đảo và kích thước các danh sách. Dòng hai chứa \(N\) số nguyên \(X_1,\ldots,X_N\). Dòng ba chứa \(N\) số nguyên \(T_1,\ldots,T_N\). Cách chúng biểu diễn nhiệt độ đã giải thích ở trên.
Với mỗi bộ test, in Case #x: y, trong đó x là số thứ tự bộ test (bắt đầu từ \(1\)), còn y là số nhiệt kế nhỏ nhất có thể tạo ra dữ liệu đầu vào.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 5/24 | 20,83% |
| Test Set 2 | 19/24 | 79,17% |
Ví dụ 1
Dữ liệu mẫu và phần giải thích chính thức được trình bày đầy đủ ngay bên dưới.
3
2 2
0 1
184 330
3 2
0 1
184 330
10 3
1 5 9
184 200 330
Case #1: 2
Case #2: 3
Case #3: 3
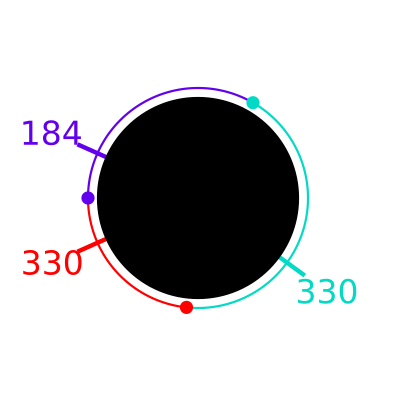
Trong mẫu số 1, cần ít nhất \(2\) nhiệt kế vì có hai nhiệt độ khác nhau. Có thể dùng đúng \(2\): một chiếc đo \(184\) tại \(0.5\), chiếc kia đo \(330\) tại \(1.5\). Điểm \(0\) và \(1\) cách đều hai chiếc nên dùng chiếc theo chiều kim đồng hồ. Nhiệt độ tại \(0\) đến từ chiếc ở \(0.5\), còn tại \(1\) đến từ chiếc ở \(1.5\).
Mẫu số 2 không thể tạo bằng chỉ \(2\) nhiệt kế. Có thể dùng \(3\) chiếc tại \(0.2\), \(1.8\), \(2.8\), lần lượt đo \(184\), \(330\), \(330\). Cũng có những cách đặt \(3\) chiếc khác cho cùng dữ liệu.
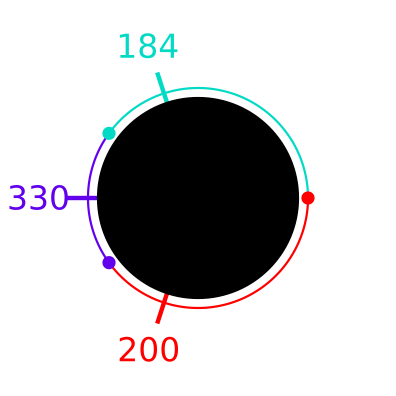
Trong mẫu số 3, một cách dùng \(3\) nhiệt kế là đặt tại \(0\), \(2\), \(8\), lần lượt đo \(330\), \(184\), \(200\).
Google Code Jam 2020, Vòng 3, bài Thermometers.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.