| # | Bài tập | Điểm | Thời gian: | Giới hạn bộ nhớ |
|---|---|---|---|---|
| 1 | Google Code Jam 2014 - Data Packing | 13 | 4.0s | 1G |
| 2 | Google Code Jam 2014 - Don't Break The Nile | 30 | 9.5s | 1G |
| 3 | Google Code Jam 2014 - Trie Sharding | 39 | 2.5s | 1G |
| 4 | Google Code Jam 2014 - Up and Down | 18 | 1.0s | 1G |
Adam, một người đàn ông ngăn nắp, luôn quan tâm sâu sắc đến việc sắp xếp đồ đạc của mình. Đặc biệt, anh nhớ lại nhiều giờ thời trẻ đã dành để chuyển các tệp tin từ máy tính sang đĩa Compact (CD).
Có hai quy tắc rất quan trọng trong thủ tục này. Thứ nhất, để đảm bảo tất cả các đĩa có thể được dán nhãn rõ ràng, Adam sẽ không bao giờ đặt quá hai tệp tin trên cùng một đĩa. Thứ hai, anh sẽ không bao giờ chia một tệp tin duy nhất sang nhiều đĩa. May mắn thay, các đĩa anh sử dụng luôn đủ lớn để thực hiện điều này.
Nhìn lại, Adam hiện đang tự hỏi liệu mình đã sắp xếp các tệp tin theo cách tốt nhất hay chưa, hay liệu anh đã lãng phí một số đĩa Compact. Anh ấy sẽ cung cấp cho bạn dung lượng của các đĩa anh ấy đã sử dụng (tất cả các đĩa của anh ấy đều có cùng dung lượng) cũng như danh sách kích thước của các tệp tin mà anh ấy đã lưu trữ. Hãy giúp Adam bằng cách xác định số lượng đĩa tối thiểu cần thiết để lưu trữ tất cả các tệp tin của anh ấy — tất nhiên là tuân theo hai quy tắc rất quan trọng nêu trên.
Dòng đầu tiên của dữ liệu vào cho biết số lượng bộ thử nghiệm, T. T bộ thử nghiệm tiếp theo. Mỗi bộ thử nghiệm bắt đầu bằng một dòng chứa hai số nguyên: số lượng tệp tin cần lưu trữ N, và dung lượng của các đĩa được sử dụng X (tính bằng MB). Dòng tiếp theo chứa N số nguyên đại diện cho kích thước của các tệp tin \(S_i\) (tính bằng MB), cách nhau bởi các khoảng trắng đơn.
Đối với mỗi bộ thử nghiệm, hãy xuất một dòng chứa "Case #x: y", trong đó x là số thứ tự bộ thử nghiệm (bắt đầu từ 1) và y là số lượng đĩa tối thiểu cần thiết để lưu trữ các tệp tin đã cho.
Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 5/13 | 38,46% |
| Test Set 2 | 8/13 | 61,54% |
Ví dụ 1
3
3 100
10 20 70
4 100
30 40 60 70
5 100
10 20 30 40 60
Case #1: 2
Case #2: 2
Case #3: 3
Google Code Jam 2014, Vòng 2, bài Data Packing.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Người ngoài hành tinh đã đổ bộ. Những người ngoài hành tinh này thấy các con sông trên Trái Đất rất thú vị vì hành tinh quê hương của họ hoàn toàn không có nước chảy, và giờ họ muốn xây dựng các công trình của mình ở một số con sông trên Trái Đất. Bạn được giao nhiệm vụ đảm bảo rằng các tòa nhà của họ không cản trở dòng chảy của những con sông này quá nhiều, điều này có thể gây ra các vấn đề nghiêm trọng. Cụ thể, bạn cần xác định lưu lượng dòng chảy tối đa mà con sông có thể duy trì là bao nhiêu, dựa trên vị trí của các tòa nhà.
Người ngoài hành tinh thích xây dựng các tòa nhà của họ trên những đoạn sông thẳng và có chiều rộng đồng nhất. Do đó, bạn quyết định mô hình hóa con sông dưới dạng một lưới hình chữ nhật, trong đó mỗi ô có tọa độ nguyên (\(X, Y\); \(0 \le X < W\) và \(0 \le Y < H\)). Mỗi ô có thể duy trì một dòng chảy là \(1\) đơn vị đi qua nó, và nước có thể chảy giữa các ô kề cạnh. Tất cả các ô ở phía nam của con sông (tức là có tọa độ \(y\) bằng \(0\)) có một dòng chảy ngầm đi vào là \(1\). Tất cả các tòa nhà đều có hình chữ nhật và căn chỉnh theo lưới. Các ô nằm dưới một tòa nhà không thể duy trì bất kỳ dòng chảy nào. Với các ràng buộc này, hãy xác định lượng dòng chảy tối đa có thể đến được các ô ở phía bắc của con sông (tức là có tọa độ \(y\) bằng \(H-1\)).
Dòng đầu tiên của dữ liệu vào cho biết số lượng bộ thử nghiệm, \(T\). \(T\) bộ thử nghiệm tiếp theo. Mỗi bộ thử nghiệm sẽ bắt đầu bằng một dòng duy nhất chứa ba số nguyên, \(W\), chiều rộng của con sông, \(H\), chiều cao của con sông, và \(B\), số lượng tòa nhà được đặt trong sông. \(B\) dòng tiếp theo sẽ mỗi dòng chứa bốn số nguyên, \(X0, Y0, X1,\) và \(Y1\). \(X0, Y0\) là tọa độ của góc dưới bên trái của tòa nhà, và \(X1, Y1\) là tọa độ của góc trên bên phải của tòa nhà. Các tòa nhà sẽ không chồng lấn lên nhau, mặc dù hai tòa nhà có thể chung cạnh.
Đối với mỗi bộ thử nghiệm, hãy xuất một dòng chứa "Case #x: m", trong đó x là số thứ tự bộ thử nghiệm (bắt đầu từ 1) và m là lưu lượng tối đa có thể đi qua sông.
Small dataset:
Large dataset:
\(3 \le W \le 1000\).
Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 10/30 | 33,33% |
| Test Set 2 | 20/30 | 66,67% |
Ví dụ 1
2
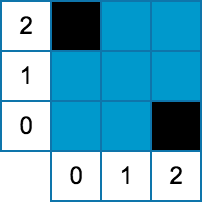
3 3 2
2 0 2 0
0 2 0 2
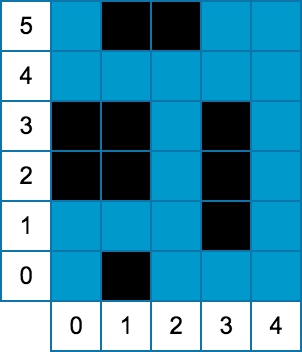
5 6 4
1 0 1 0
3 1 3 3
0 2 1 3
1 5 2 5
Case #1: 1
Case #2: 2
Google Code Jam 2014, Vòng 2, bài Don't Break The Nile.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Một tập hợp các chuỗi \(S\) có thể được lưu trữ hiệu quả trong một trie. Một trie là một cây có gốc, trong đó mỗi nút đại diện cho một tiền tố của mọi chuỗi trong \(S\), không trùng lặp.
Ví dụ, nếu \(S\) là "AAA", "AAB", "AB", "B", trie tương ứng sẽ chứa 7 nút tương ứng với các tiền tố "", "A", "AA", "AAA", "AAB", "AB", và "B".
Tôi có một máy chủ chứa \(S\) trong một trie lớn. Không may, \(S\) đã trở nên rất lớn và tôi gặp khó khăn khi lưu trữ mọi thứ trong bộ nhớ trên một máy chủ. Để giải quyết vấn đề này, tôi muốn chuyển sang lưu trữ \(S\) trên \(N\) máy chủ riêng biệt. Cụ thể, \(S\) sẽ được chia thành các tập con không giao nhau và không rỗng \(T_1, T_2, \dots, T_N\), và trên mỗi máy chủ \(i\), tôi sẽ xây dựng một trie chỉ chứa các chuỗi trong \(T_i\). Nhược điểm của cách tiếp cận này là tổng số nút trên tất cả \(N\) trie có thể tăng lên. Tệ hơn nữa, tôi không thể kiểm soát cách tập hợp các chuỗi được chia nhỏ!
Ví dụ, giả sử "AAA", "AAB", "AB", "B" được chia vào hai máy chủ, một máy chứa "AAA" và "B", và máy kia chứa "AAB", "AB". Khi đó trie trên máy chủ thứ nhất sẽ cần 5 nút ("", "A", "AA", "AAA", "B"), và trie trên máy chủ thứ hai cũng sẽ cần 5 nút ("", "A", "AA", "AAB", "AB"). Trong trường hợp này, tôi sẽ cần tổng cộng 10 nút trên hai máy chủ, trái ngược với 7 nút nếu tôi có thể để mọi thứ trên chỉ một máy chủ.
Cho một cách phân bổ các chuỗi vào \(N\) máy chủ, tôi muốn tính tổng số nút lớn nhất có thể có trên tất cả các máy chủ trong trường hợp xấu nhất, và khả năng điều đó xảy ra là bao nhiêu. Sau đó, tôi có thể quyết định xem kế hoạch của mình là tốt hay quá rủi ro.
Cho \(S\) và \(N\), số lượng nút lớn nhất mà tôi có thể nhận được là bao nhiêu? Ngoài ra, có bao nhiêu cách chọn \(T_1, T_2, \dots, T_N\) để số lượng nút là tối đa? Lưu ý rằng \(N\) máy chủ là khác nhau -- nếu một chuỗi xuất hiện trong \(T_i\) ở một cách sắp xếp và trong \(T_j\) (\(i \neq j\)) ở một cách sắp xếp khác, thì hai cách sắp xếp đó được coi là khác nhau. Hãy in ra phần dư của số cách sắp xếp có thể sau khi chia cho \(1,000,000,007\).
Dòng đầu tiên của đầu vào cho biết số lượng bộ dữ liệu, \(T\). \(T\) bộ dữ liệu tiếp theo. Mỗi bộ dữ liệu bắt đầu bằng một dòng chứa hai số nguyên cách nhau bởi dấu cách: \(M\) và \(N\). \(M\) dòng tiếp theo, mỗi dòng chứa một chuỗi trong \(S\).
Đối với mỗi bộ dữ liệu, hãy xuất một dòng chứa "Case #\(i\): \(X\) \(Y\)", trong đó \(i\) là số thứ tự của bộ dữ liệu (bắt đầu từ 1), \(X\) là số lượng nút tối đa trong trường hợp xấu nhất trên tất cả các trie kết hợp lại, và \(Y\) là số cách (theo mô-đun \(1,000,000,007\)) để phân bổ các chuỗi vào các máy chủ sao cho tổng số nút là \(X\).
Small dataset:
Large dataset:
\(1 \le M \le 1000\).
Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 9/39 | 23,08% |
| Test Set 2 | 30/39 | 76,92% |
Ví dụ 1
2
4 2
AAA
AAB
AB
B
5 2
A
B
C
D
E
Case #1: 10 8
Case #2: 7 30
Google Code Jam 2014, Vòng 2, bài Trie Sharding.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.
Bạn được cho một dãy gồm các số nguyên phân biệt \(A = [A_1, A_2, ..., A_N]\), và muốn sắp xếp lại nó thành một dãy lên và xuống (một dãy mà \(A_1 < A_2 < ... < A_m > A_{m+1} > ... > A_N\) với một chỉ số \(m\) nào đó, \(m\) nằm trong khoảng từ \(1\) đến \(N\) bao gồm cả hai đầu).
Việc sắp xếp lại được thực hiện bằng cách hoán đổi hai phần tử kề nhau của dãy tại một thời điểm. Như dự đoán, bạn đặc biệt quan tâm đến số lượng hoán đổi ít nhất cần thiết để đạt được một dãy lên và xuống.
Dòng đầu tiên của dữ liệu vào cho biết số lượng bộ test, \(T\). \(T\) bộ test theo sau. Mỗi bộ test bắt đầu bằng một dòng chứa một số nguyên duy nhất: \(N\). Dòng tiếp theo chứa \(N\) số nguyên phân biệt: \(A_1, ..., A_N\).
Với mỗi bộ test, hãy xuất một dòng chứa "Case #x: y", trong đó x là số thứ tự bộ test (bắt đầu từ 1) và y là số lượng hoán đổi tối thiểu cần thiết để sắp xếp lại \(A\) thành một dãy lên và xuống.
Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.
| Phân nhóm | Điểm Google Code Jam | Tỷ lệ điểm của bài |
|---|---|---|
| Test Set 1 | 7/18 | 38,89% |
| Test Set 2 | 11/18 | 61,11% |
Ví dụ 1
2
3
1 2 3
5
1 8 10 3 7
Case #1: 0
Case #2: 1
Trong trường hợp đầu tiên, dãy đã ở dạng mong muốn (với \(m=N=3\)) nên không cần hoán đổi nào.
Trong trường hợp thứ hai, hoán đổi 3 và 7 tạo ra một dãy lên và xuống (với \(m=3\)).
Google Code Jam 2014, Vòng 2, bài Up and Down.
Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.