Google Code Jam 2011 - Round 1B

Bộ đề bài

# Bài tập Điểm Thời gian: Giới hạn bộ nhớ
1 Google Code Jam 2011 - House of Kittens 45 1.0s 1G
2 Google Code Jam 2011 - Revenge of the Hot Dogs 35 6.0s 1G
3 Google Code Jam 2011 - RPI 20 1.0s 1G

1. Google Code Jam 2011 - House of Kittens

Điểm: 45 Thời gian: 1.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Bạn vừa mới nhận nuôi một vài chú mèo con, và bây giờ bạn muốn xây một ngôi nhà cho chúng. Nhìn từ bên ngoài, ngôi nhà sẽ có hình dạng của một đa giác lồi với \(N\) đỉnh. Bên trong, nó được chia thành nhiều phòng bởi \(M\) bức tường nội thất nối các đỉnh theo đường thẳng. Không có hai bức tường nào cắt nhau, nhưng có thể có nhiều bức tường chạm vào cùng một đỉnh.

Tại sao ngôi nhà mèo của bạn lại đặc biệt như vậy? Tại mỗi đỉnh, bạn sẽ xây dựng một cây cột hoàn toàn bằng cỏ mèo (catnip)! Mèo con sẽ có thể chơi với bất kỳ cây cột nào chạm vào căn phòng mà chúng đang ở, mang lại cho chúng một ngôi nhà thực sự sang trọng.

Để làm cho ngôi nhà thú vị hơn nữa, bạn muốn sử dụng các loại hương vị cỏ mèo khác nhau. Một cây cột chỉ có thể sử dụng một hương vị, nhưng các cây cột khác nhau có thể sử dụng các hương vị khác nhau. Có một vấn đề duy nhất: nếu một căn phòng nào đó không được tiếp cận với tất cả các loại hương vị cỏ mèo trong nhà, thì những chú mèo con trong phòng đó sẽ cảm thấy bị bỏ rơi và buồn bã.

Nhiệm vụ của bạn là chọn hương vị cỏ mèo nào để sử dụng cho mỗi đỉnh sao cho (a) mọi hương vị đều có thể tiếp cận được từ mọi phòng, và (b) sử dụng được càng nhiều loại hương vị càng tốt.

Trong ví dụ dưới đây, ba loại hương vị khác nhau (được đại diện bởi các chấm đỏ, xanh lá cây và xanh dương) được phân bổ trong một ngôi nhà 8 cạnh trong khi vẫn giữ cho mèo con ở mọi phòng đều hạnh phúc:
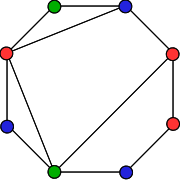
Trong hình trên, bắt đầu từ góc bên trái của bức tường phía trên và đi theo chiều kim đồng hồ, các màu ở đây là: xanh lá cây, xanh dương, đỏ, đỏ, xanh dương, xanh lá cây, xanh dương, đỏ.

Dữ liệu vào

Dòng đầu tiên của đầu vào cho biết số lượng bộ thử nghiệm, \(T\). \(T\) bộ thử nghiệm tiếp theo.

Mỗi bộ thử nghiệm gồm ba dòng. Dòng đầu tiên cho biết \(N\)\(M\), số lượng đỉnh và số bức tường nội thất trong ngôi nhà mèo của bạn. Dòng thứ hai cho các số nguyên cách nhau bởi dấu cách \(U_1, U_2, \dots, U_M\) mô tả nơi mỗi bức tường nội thất bắt đầu. Dòng thứ ba cho các số nguyên cách nhau bởi dấu cách \(V_1, V_2, \dots, V_M\) mô tả nơi mỗi bức tường nội thất kết thúc.

Chính xác hơn, nếu các đỉnh của ngôi nhà mèo được đánh số \(1, 2, \dots, N\) theo chiều kim đồng hồ, thì các bức tường nội thất nằm giữa các đỉnh \(U_i\)\(V_i\).

Dữ liệu ra

Đối với mỗi bộ thử nghiệm, hãy xuất ra hai dòng. Dòng đầu tiên phải là Case #x: C, trong đó x là số thứ tự bộ thử nghiệm và C là số lượng hương vị cỏ mèo tối đa có thể được sử dụng. Dòng thứ hai phải chứa \(N\) số nguyên cách nhau bởi dấu cách: y_1 y_2 ... y_N, trong đó \(y_i\) là một số nguyên từ \(1\) đến \(C\) cho biết hương vị cỏ mèo nào bạn đã gán cho đỉnh \(i\).

Nếu có nhiều cách gán với \(C\) hương vị, bạn có thể xuất ra bất kỳ cách nào trong số đó.

Ràng buộc

  • \(1 \le T \le 100\).
  • \(1 \le M \le N - 3\).
  • \(1 \le U_i < V_i \le N\) với mọi \(i\).
  • Các bức tường nội thất không chạm nhau ngoại trừ tại \(N\) đỉnh.
  • Các bức tường nội thất không chạm vào bên ngoài ngôi nhà ngoại trừ tại \(N\) đỉnh.

Phân nhóm

  • Test set 1 (Visible): \(4 \le N \le 8\).
  • Test set 2 (Hidden): \(4 \le N \le 2000\).

Điểm các phân nhóm

Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.

Phân nhóm Điểm Google Code Jam Tỷ lệ điểm của bài
Test Set 1 20/45 44,44%
Test Set 2 25/45 55,56%

Ví dụ

Ví dụ 1

Input
2
4 1
2
4
8 3
1 1 4
3 7 7
Output
Case #1: 3
1 2 1 3
Case #2: 3
1 2 3 1 1 3 2 3

Nguồn

Google Code Jam 2011, Vòng 1B, bài House of Kittens.

Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.

2. Google Code Jam 2011 - Revenge of the Hot Dogs

Điểm: 35 Thời gian: 6.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Năm ngoái, một vài người bán xúc xích đã xếp hàng dọc theo một con phố, và họ có một thuật toán phức tạp để tự giãn cách nhau ra. Thật không may, thuật toán đó rất chậm và họ vẫn đang thực hiện nó. Tuy nhiên, mọi thứ vẫn chưa mất hết! Những người bán xúc xích đã có một kế hoạch: đã đến lúc thử một thuật toán mới!

Vấn đề là nhiều người bán có thể đang đứng quá gần nhau, và khi đó họ sẽ tranh giành khách hàng của nhau. Những người bán có thể di chuyển dọc theo con phố với tốc độ \(1\) mét/giây. Để tránh cản trở nhau, họ muốn đứng sao cho mọi cặp người bán cách nhau một khoảng ít nhất là \(D\) mét.

Hãy nhớ rằng con phố rất dài, vì vậy không có nguy cơ hết chỗ để di chuyển theo cả hai hướng. Cho biết vị trí bắt đầu của tất cả các người bán xúc xích, bạn nên tìm thời gian tối thiểu cần thiết trước khi tất cả các người bán được giãn cách (mỗi hai người bán cách nhau ít nhất \(D\) mét).

Dữ liệu vào

Mỗi điểm trên con phố được gắn nhãn bằng một con số, có thể là số dương, số âm hoặc số không. Một điểm có nhãn \(p\) nằm cách điểm có nhãn \(0\)\(|p|\) mét về phía đông nếu \(p\) dương, và \(|p|\) mét về phía tây nếu \(p\) âm. Chúng tôi sẽ sử dụng hệ thống nhãn này để mô tả vị trí của các người bán trong tệp dữ liệu vào.

Dòng đầu tiên của dữ liệu vào chứa số lượng bộ test, \(T\). \(T\) bộ test tiếp theo. Mỗi bộ test bắt đầu bằng một dòng chứa số lượng điểm \(C\) có ít nhất một người bán xúc xích trong cấu hình bắt đầu và một số nguyên \(D\) -- khoảng cách tối thiểu họ muốn giãn cách. \(C\) dòng tiếp theo mỗi dòng chứa một cặp số nguyên \(P, V\) cách nhau bởi dấu cách, cho biết có \(V\) người bán tại điểm có nhãn \(P\).

Dữ liệu ra

Đối với mỗi bộ test, hãy xuất một dòng chứa "Case #x: y", trong đó x là số thứ tự bộ test (bắt đầu từ 1) và y là lượng thời gian tối thiểu để những người bán giãn cách nhau trên con phố. Các câu trả lời có sai số tương đối hoặc tuyệt đối tối đa \(10^{-6}\) sẽ được chấp nhận.

Ràng buộc

  • \(1 \le T \le 50\).
  • Tất cả các giá trị \(P\) là số nguyên trong phạm vi \([-10^5, 10^5]\).
  • Trong mỗi bộ test, tất cả các giá trị \(P\) là duy nhất và được đưa ra theo thứ tự tăng dần. Giới hạn về tổng các giá trị \(V\) được liệt kê bên dưới. Tất cả các giá trị \(V\) là số nguyên dương.

Phân nhóm

  • Small dataset (Test set 1 - Visible):

    • \(1 \le D \le 5\).
    • \(1 \le C \le 20\).
    • Tổng tất cả các giá trị \(V\) trong một bộ test không vượt quá \(100\).
  • Large dataset (Test set 2 - Hidden):

    • \(1 \le D \le 10^6\).
    • \(1 \le C \le 200\).
    • Tổng tất cả các giá trị \(V\) không vượt quá \(10^6\).

Điểm các phân nhóm

Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.

Phân nhóm Điểm Google Code Jam Tỷ lệ điểm của bài
Test Set 1 15/35 42,86%
Test Set 2 20/35 57,14%

Ví dụ

Ví dụ 1

Input
2
3 2
0 1
3 2
6 1
2 2
0 3
1 1
Output
Case #1: 1.0
Case #2: 2.5

Nguồn

Google Code Jam 2011, Vòng 1B, bài Revenge of the Hot Dogs.

Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.

3. Google Code Jam 2011 - RPI

Điểm: 20 Thời gian: 1.0s Bộ nhớ: 1G Input: bàn phím Output: màn hình

Ở Hoa Kỳ, 350 trường học thi đấu mỗi năm để giành lời mời tham dự Giải bóng rổ đại học NCAA. Với số lượng trường lớn như vậy, làm thế nào để quyết định ai nên được mời? Hầu hết các đội không bao giờ đối đầu với nhau, và một số đội có lịch thi đấu khó khăn hơn nhiều so với những đội khác.

Dưới đây là một ví dụ về lịch thi đấu cho 4 đội tên là A, B, C, 😩

   |ABCD
  -+----
  A|.11.
  B|0.00
  C|01.1
  D|.10.

Mỗi số 1 trong hàng của một đội đại diện cho một trận thắng, và mỗi số 0 đại diện cho một trận thua. Vì vậy, đội C có các trận thắng trước B và D, và một trận thua trước A. Đội A có các trận thắng trước B và C, nhưng chưa đấu với D.

Ủy ban giải đấu NCAA sử dụng một công thức gọi là RPI (Ratings Percentage Index - Chỉ số phần trăm xếp hạng) để giúp xếp hạng các đội. Theo truyền thống, nó được định nghĩa như sau:

  RPI = 0.25 * WP + 0.50 * OWP + 0.25 * OOWP

WP, OWP, và OOWP được định nghĩa cho mỗi đội như sau:

  • WP (Winning Percentage - Tỉ lệ thắng) là tỉ số giữa số trận thắng trên tổng số trận đã đấu của đội bạn.
    Trong lịch thi đấu ví dụ, đội A có WP = 1, đội B có WP = 0, đội C có WP = 2/3, và đội D có WP = 0.5.
  • OWP (Opponents' Winning Percentage - Tỉ lệ thắng của các đối thủ) là trung bình cộng WP của tất cả các đối thủ của bạn, sau khi đã loại bỏ các trận đấu mà họ đã đấu với bạn.
    Ví dụ, nếu bạn loại bỏ các trận đấu với đội D, thì đội B có WP = 0 và đội C có WP = 0.5. Do đó, đội D có OWP = 0.5 * (0 + 0.5) = 0.25. Tương tự, đội A có OWP = 0.5, đội B có OWP = 0.5, và đội C có OWP = 2/3.
  • OOWP (Opponents' Opponents' Winning Percentage - Tỉ lệ thắng của đối thủ của các đối thủ) là trung bình cộng OWP của tất cả các đối thủ của bạn. OWP chính là con số được tính ở bước trước đó.
    Ví dụ, đội A có OOWP = 0.5 * (0.5 + 2/3) = 7/12.

Tổng hợp lại, ta thấy đội A có RPI = (0.25 * 1) + (0.5 * 0.5) + (0.25 * 7 / 12) = 0.6458333...

Có một số câu hỏi khá thú vị mà bạn có thể đặt ra về RPI. Liệu nó có phải là một thước đo hợp lý về khả năng của đội bóng? Việc thắng các trận đấu quan trọng hơn, hay việc sắp xếp lịch thi đấu với các đối thủ mạnh quan trọng hơn? Đó đều là những câu hỏi hay, nhưng đối với bài toán này, nhiệm vụ của bạn đơn giản hơn: cho trước lịch thi đấu của các trận đấu, bạn hãy tính RPI của mọi đội.

Dữ liệu vào

Dòng đầu tiên của dữ liệu vào cho biết số lượng bộ test, T. T bộ test nối tiếp theo. Mỗi bộ test bắt đầu bằng một dòng duy nhất chứa số lượng đội N.

N dòng tiếp theo mỗi dòng chứa đúng N ký tự (có thể là '0', '1', hoặc '.') đại diện cho lịch thi đấu theo cùng định dạng như ví dụ trên. Ký tự '1' ở hàng i, cột j cho biết đội i đã thắng đội j, ký tự '0' ở hàng i, cột j cho biết đội i đã thua đội j, và ký tự '.' ở hàng i, cột j cho biết đội i chưa bao giờ đấu với đội j.

Dữ liệu ra

Với mỗi bộ test, xuất ra N + 1 dòng. Dòng đầu tiên phải là "Case #x:" trong đó x là số thứ tự bộ test (bắt đầu từ 1). N dòng tiếp theo phải chứa RPI của mỗi đội, mỗi đội trên một dòng, theo cùng thứ tự như trong lịch thi đấu.

Các câu trả lời có sai số tương đối hoặc tuyệt đối không quá 10⁻⁶ sẽ được coi là chính xác.

Ràng buộc

  • 1 ≤ T ≤ 20.
  • Nếu lịch thi đấu có '1' ở hàng i, cột j, thì nó sẽ có '0' ở hàng j, cột i.
  • Nếu lịch thi đấu có '0' ở hàng i, cột j, thì nó sẽ có '1' ở hàng j, cột i.
  • Nếu lịch thi đấu có '.' ở hàng i, cột j, thì nó sẽ có '.' ở hàng j, cột i.
  • Mỗi đội đấu với ít nhất hai đội khác.
  • Không có hai đội nào đấu với nhau hai lần.
  • Không đội nào tự đấu với chính mình.

Phân nhóm

  • Test set 1 (Visible): 3 ≤ N ≤ 10.
  • Test set 2 (Hidden): 3 ≤ N ≤ 100.

Điểm các phân nhóm

Mỗi Test Set tương ứng với một subtask trên LQDOJ. Bảng dưới đây giữ nguyên điểm chính thức của Google Code Jam và quy đổi tỷ lệ trên tổng điểm của bài.

Phân nhóm Điểm Google Code Jam Tỷ lệ điểm của bài
Test Set 1 8/20 40%
Test Set 2 12/20 60%

Ví dụ

Ví dụ 1

Input
2
3
.10
0.1
10.
4
.11.
0.00
01.1
.10.
Output
Case #1:
0.5
0.5
0.5
Case #2:
0.645833333333
0.368055555556
0.604166666667
0.395833333333

Nguồn

Google Code Jam 2011, Vòng 1B, bài RPI.

Nguồn chính thức trên Google Coding Competitions Archive, phát hành theo giấy phép Apache-2.0.