| # | Bài tập | Điểm | Thời gian: | Giới hạn bộ nhớ |
|---|---|---|---|---|
| 1 | BOI 2025 - BOI acronym | 100 (p) | 2.0s | 256M |
| 2 | BOI 2025 - Tour | 100 (p) | 3.0s | 1G |
| 3 | BOI 2025 - Tower | 100 (p) | 3.0s | 256M |
BOI là tên viết tắt của Baltic Olympiad in Informatics — kỳ thi Olympic Tin học Baltic.
Ban tổ chức thấy tên viết tắt BOI quá dễ phát âm, vì trong tiếng Anh nó chỉ có một âm tiết. Vì vậy, họ đã nghĩ ra một tên viết tắt mới. Để dễ phân biệt với các kỳ thi Olympic khu vực khác, chẳng hạn CEOI, tên mới vẫn chỉ gồm các ký tự B, O và I. Ngoài ra, B phải là ký tự xuất hiện nhiều nhất một cách nghiêm ngặt: số lần xuất hiện của B phải lớn hơn số lần xuất hiện của O, đồng thời lớn hơn số lần xuất hiện của I.
Ví dụ, OBOIIBB và B là những tên viết tắt hợp lệ, còn IBIIBB, BOI, O và BCB thì không.
Để mọi chuyện thú vị hơn, thay vì công bố toàn bộ tên mới, ban tổ chức chỉ đưa ra một số gợi ý. Cụ thể, với mỗi xâu con liên tiếp của tên mới, họ cho biết số lần xuất hiện của ký tự xuất hiện nhiều nhất trong xâu con đó. Ký tự này không nhất thiết là B, và có thể có nhiều ký tự cùng đạt số lần xuất hiện lớn nhất. Điều đáng ngạc nhiên là có thể chứng minh những thông tin này đủ để xác định tất cả các vị trí xuất hiện của B. Hãy tìm các vị trí đó.
Dòng đầu tiên chứa số nguyên \(n\), là độ dài của tên viết tắt mới.
\(n\) dòng tiếp theo mô tả các gợi ý. Dòng thứ \(i\) trong số này chứa \(n-i+1\) số nguyên \(M_{i,i}, M_{i,i+1}, \ldots, M_{i,n}\). Trong đó, \(M_{\ell,r}\) là số lần xuất hiện của ký tự xuất hiện nhiều nhất trong xâu con bắt đầu ở vị trí \(\ell\) và kết thúc ở vị trí \(r\). Các vị trí được đánh số từ \(1\) đến \(n\).
Dữ liệu bảo đảm tồn tại ít nhất một tên viết tắt hợp lệ phù hợp với tất cả các gợi ý.
In trên một dòng tất cả các vị trí xuất hiện của B theo thứ tự tăng dần, cách nhau bởi một dấu cách. Mỗi vị trí là một số nguyên từ \(1\) đến \(n\).
B và O.Ví dụ 1
6
1 1 2 3 3 3
1 1 2 2 2
1 2 2 2
1 1 2
1 2
1
1 3 4
Toruń có rất nhiều điểm tham quan. Các hướng dẫn viên đã chuẩn bị một danh sách gồm \(m\) tuyến đi bộ một chiều nối \(n\) điểm hẹn trong trung tâm thành phố. Các tuyến đi bộ được đánh số từ \(1\) đến \(m\), còn các điểm hẹn được đánh số từ \(1\) đến \(n\). Mỗi tuyến đi từ một điểm hẹn đến một điểm hẹn khác và cho phép người tham gia ghé thăm đúng một điểm tham quan trên đường. Nhiều tuyến có thể đi qua cùng một điểm tham quan, và có thể có nhiều tuyến nối cùng một cặp điểm hẹn. Chúng ta muốn tổ chức một chuyến tham quan thú vị vào ngày nghỉ.
Một chuyến tham quan là một dãy các tuyến đi bộ, trong đó mỗi tuyến bắt đầu tại điểm hẹn mà tuyến trước đó kết thúc. Ngoài ra, tuyến cuối cùng phải kết thúc tại điểm hẹn mà tuyến đầu tiên bắt đầu.
Chuyến tham quan được gọi là thú vị nếu không ghé thăm cùng một điểm tham quan hai lần liên tiếp. Nói cách khác, hai tuyến liên tiếp bất kỳ phải đi qua hai điểm tham quan khác nhau; tuyến đầu tiên và tuyến cuối cùng cũng phải đi qua hai điểm tham quan khác nhau. Các tuyến không liên tiếp vẫn được phép đi qua cùng một điểm tham quan. Đặc biệt, có thể sử dụng cùng một tuyến đi bộ nhiều lần trong chuyến tham quan, nhưng không được sử dụng hai lần liên tiếp.
Hãy xác định xem có thể tổ chức một chuyến tham quan thú vị hay không, và nếu có, hãy tìm một chuyến như vậy. Bạn được phép đưa ra bất kỳ chuyến tham quan thú vị nào gồm không quá \(m\) tuyến đi bộ. Có thể chứng minh rằng nếu tồn tại một chuyến tham quan thú vị thì cũng tồn tại một chuyến như vậy gồm không quá \(m\) tuyến.
Dòng đầu tiên chứa số nguyên dương \(t\), là số bộ dữ liệu.
Dòng đầu tiên của mỗi bộ dữ liệu chứa hai số nguyên dương \(n\) và \(m\), lần lượt là số điểm hẹn và số tuyến đi bộ.
Trong \(m\) dòng tiếp theo, dòng thứ \(i\) chứa ba số nguyên dương \(x_i\), \(y_i\) và \(c_i\), mô tả tuyến đi bộ thứ \(i\): tuyến này bắt đầu tại điểm hẹn \(x_i\), kết thúc tại điểm hẹn \(y_i\) và đi qua điểm tham quan \(c_i\).
Gọi \(N\) và \(M\) lần lượt là tổng các giá trị \(n\) và tổng các giá trị \(m\) trên tất cả các bộ dữ liệu.
Với mỗi bộ dữ liệu, in YES trên dòng đầu tiên nếu có thể tổ chức một chuyến tham quan thú vị; ngược lại, in NO.
Nếu in YES, trên dòng thứ hai, in số nguyên \(k\) với \(2 \le k \le m\), là số tuyến đi bộ trong chuyến tham quan. Tiếp theo trên cùng dòng, in \(k\) số nguyên \(p_1, p_2, \ldots, p_k\), cách nhau bởi một dấu cách, là chỉ số các tuyến theo thứ tự sử dụng. Chuyến tham quan bắt đầu bằng tuyến \(p_1\), tiếp tục với tuyến \(p_2\), và cuối cùng đi theo tuyến \(p_k\) để trở về điểm hẹn xuất phát. Dãy được in phải mô tả một chuyến tham quan thú vị; mỗi \(p_i\) nằm trong đoạn từ \(1\) đến \(m\).
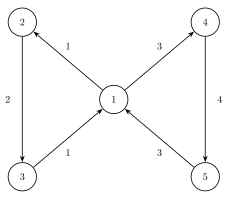
Ví dụ 1
5
3 3
1 2 1
2 3 2
3 1 1
3 3
2 1 1
1 3 3
3 1 2
2 2
1 2 2
1 2 1
5 6
1 2 1
2 3 2
3 1 1
1 4 3
4 5 4
5 1 3
4 4
1 3 4
3 2 1
2 3 2
2 3 2
NO
YES
2 2 3
NO
YES
6 3 4 5 6 1 2
YES
4 2 4 2 3
Có nhiều truyền thuyết về tháp nghiêng Toruń. Bức tường của tháp có dạng một đường tròn với \(n \ge 3\) cánh cửa cách đều nhau, tức là các cánh cửa nằm tại các đỉnh của một đa giác đều \(n\) cạnh. Các cửa được đánh số từ \(0\) đến \(n-1\) theo một thứ tự ngẫu nhiên. Cách chọn thứ tự này được mô tả trong phần Phân nhóm.
Một truyền thuyết ít người biết kể rằng mỗi cư dân mới của tháp đều phải vượt qua một thử thách: liệt kê các cánh cửa, bắt đầu từ một cửa bất kỳ rồi đi một vòng theo chiều kim đồng hồ hoặc ngược chiều kim đồng hồ, ghé qua mỗi cửa đúng một lần.
Thử thách phải được hoàn thành mà không được nhìn thấy tháp. Thay vào đó, cư dân mới có thể đặt câu hỏi như sau: “Với ba cửa phân biệt \(x\), \(y\), \(z\), những cặp cửa nào trong ba cặp \(\{x,y\}\), \(\{y,z\}\) và \(\{z,x\}\) gần nhau nhất?”. Câu trả lời gồm tất cả các cặp trong ba cặp trên có khoảng cách Euclid nhỏ nhất. Khoảng cách giữa hai cửa là độ dài đoạn thẳng ngắn nhất nối chúng.
Hãy viết chương trình sử dụng ít câu hỏi để xác định thứ tự các cửa.
Bản chuyển đổi này sử dụng giao diện hàm C++. Nộp một tệp C++17 hoặc C++20, thêm #include "tower.h" và cài đặt hai hàm sau. Tệp khai báo tower.h được cung cấp trong phần đính kèm.
void Init(int T, int K);
void Solve(int n);
Trình chấm gọi Init(T, K) đúng một lần khi bắt đầu bài kiểm tra: T là số bộ dữ liệu và K là số truy vấn trung bình tối đa. Sau đó trình chấm gọi Solve(n) đúng T lần, theo thứ tự bộ dữ liệu. Mỗi lần gọi tương ứng với một tháp mới có n cửa; biến toàn cục của chương trình vẫn được giữ giữa các lần gọi. Trong phần còn lại của đề, \(t=T\) và \(k=K\).
Trong Solve, bạn được sử dụng hai hàm do trình chấm cung cấp:
std::vector<std::pair<int, int>> Query(int x, int y, int z);
void Answer(const std::vector<int>& order);
Query(x, y, z) đặt một câu hỏi về ba cửa phân biệt thuộc đoạn \([0,n-1]\) và trả về tất cả các cặp có khoảng cách nhỏ nhất. Kết quả có từ \(1\) đến \(3\) cặp; mỗi cặp (a, b) thỏa mãn a < b. Không được giả định thứ tự của các cặp trong kết quả. Mỗi lần gọi tính là một truy vấn, kể cả truy vấn lặp lại.Answer(order) gửi một hoán vị gồm đúng n số nguyên, mô tả thứ tự các cửa khi đi một vòng quanh tháp. Mọi phép quay và đảo chiều của thứ tự đúng đều được chấp nhận, tổng cộng \(2n\) đáp án đúng. Phải gọi Answer đúng một lần trong mỗi lần gọi Solve, rồi trả về từ Solve. Không được gọi Query hoặc Answer thêm sau khi đã gửi đáp án.Không gọi Query hoặc Answer trong Init hay bên ngoài Solve. Không cài đặt main, không đọc đầu vào chuẩn, không ghi đầu ra chuẩn, không mở tệp hoặc truy cập tài nguyên khác. Có thể ghi vào luồng lỗi chuẩn để gỡ lỗi; thời gian ghi vẫn được tính. Trình chấm chịu trách nhiệm đọc dữ liệu và xuất kết quả.
Trả về mà chưa gửi đáp án, gửi đáp án sai, gọi hàm sai quy định hoặc vượt tổng số truy vấn \(T\cdot K\) đều làm cả phân nhóm nhận \(0\) điểm. Giới hạn truy vấn áp dụng cho tổng của bài kiểm tra, không phải riêng từng tháp. Thứ tự các cửa đã được cố định từ trước và không thay đổi theo các truy vấn.
Mỗi phân nhóm có đúng một bài kiểm tra gồm đúng \(t=100\) bộ dữ liệu. Số truy vấn trung bình của một bài kiểm tra được tính bằng tổng số truy vấn trên tất cả các bộ dữ liệu chia cho số bộ dữ liệu. Nếu giá trị trung bình này lớn hơn \(k\) của phân nhóm, bạn nhận \(0\) điểm cho phân nhóm đó. Nếu không vượt quá \(k\), bạn nhận toàn bộ điểm của các phân nhóm từ \(1\) đến \(4\).
Với phân nhóm cuối cùng, gọi \(k^*\) là số truy vấn trung bình thực tế mà chương trình sử dụng. Khi không vượt quá giới hạn truy vấn, số điểm được tính bằng:
Biểu thức bên trong dấu làm tròn tăng tuyến tính từ \(0\) đến \(56\) khi \(k^*\) giảm từ \(12000\) xuống \(4200\); số điểm được làm tròn lên đến số nguyên gần nhất.
Nếu chương trình đưa ra đáp án sai ở bất kỳ bộ dữ liệu nào, bạn nhận \(0\) điểm cho cả phân nhóm đó, bất kể số truy vấn đã sử dụng.
Mỗi bộ dữ liệu được sinh bằng cách chọn \(n\) ngẫu nhiên đều trong tất cả các giá trị thỏa mãn ràng buộc của phân nhóm, rồi chọn thứ tự các cửa ngẫu nhiên đều trong tất cả các thứ tự của \(n\) cửa thỏa mãn ràng buộc của phân nhóm đó.
Giả sử có một bộ dữ liệu với \(n=6\) và thứ tự các cửa là \(5,3,0,2,1,4\). Một chuỗi lời gọi hợp lệ là:
| Lời gọi | Kết quả / hành động |
|---|---|
Init(1, 100) |
Trình chấm thông báo có một bộ dữ liệu, giới hạn trung bình là \(100\) truy vấn. |
Solve(6) |
Trình chấm yêu cầu xử lý tháp có \(6\) cửa. |
Query(0, 1, 2) |
Trả về các cặp (0, 2) và (1, 2). |
Query(4, 1, 3) |
Trả về cặp (1, 4). |
Query(0, 5, 1) |
Trả về các cặp (0, 5), (0, 1) và (1, 5). |
Answer({4, 5, 3, 0, 2, 1}) |
Gửi một thứ tự đúng; sau đó Solve trả về. |
Đây là minh họa giao diện, không phải thuật toán suy ra đáp án chỉ từ ba truy vấn này. Ví dụ có \(t=1\); mỗi bài kiểm tra tính điểm chính thức có \(t=100\).
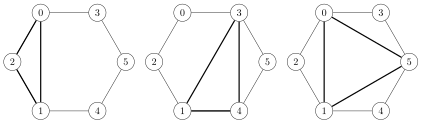
Ở hình bên trái, các cửa \(0\), \(1\), \(2\) tương ứng với truy vấn đầu tiên; hai cặp \(\{0,2\}\) và \(\{1,2\}\) có khoảng cách nhỏ nhất. Ở hình giữa, cặp \(\{1,4\}\) có khoảng cách nhỏ nhất trong ba cửa \(4\), \(1\), \(3\). Ở hình bên phải, cả ba cặp giữa các cửa \(0\), \(5\), \(1\) đều có cùng khoảng cách.
Các dãy \(0,2,1,4,5,3\) hoặc \(5,4,1,2,0,3\) cũng là đáp án đúng.