| # | Bài tập | Điểm | Thời gian: | Giới hạn bộ nhớ |
|---|---|---|---|---|
| 1 | BOI 2021 - A Difficult(y) Choice | 100 (p) | 2.0s | 512M |
| 2 | BOI 2021 - Inside information | 100 (p) | 4.0s | 512M |
| 3 | BOI 2021 - From Hacks to Snitches | 100 (p) | 5.0s | 512M |
Vinh quang bất diệt thuộc về những ai giành được huy chương BOI. Bạn cũng muốn trở thành một trong số họ, và con đường dành cho bạn là luyện tập, luyện tập, rồi lại luyện tập! “Có thật vậy không?”, một giọng nói nhỏ trong đầu bạn khẽ hỏi.
Bước đầu tiên trong kế hoạch luyện tập là mua một số sách khoa học máy tính. May mắn thay, hiệu sách gần nhà đang giảm giá rất nhiều nếu bạn mua đúng \(K\) quyển.
Bạn cần chọn \(K\) quyển trong số \(N\) quyển sách khoa học máy tính được bán tại cửa hàng, đánh số từ \(1\) đến \(N\). Tiêu chí lựa chọn chính của bạn là độ khó: mỗi quyển sách \(i\) có một độ khó riêng, hoàn toàn khách quan, là \(x_i\); tổng độ khó của một tập sách bằng tổng độ khó của từng quyển trong tập đó. Bạn không muốn sách quá dễ, vì như vậy sẽ không học đủ để giành huy chương quý giá, cũng không muốn sách quá khó, vì sẽ không kịp hiểu trước khi cuộc thi bắt đầu. Cụ thể, tổng độ khó của những quyển sách được chọn phải ít nhất là \(A\) và không quá \(2A\).
Muốn biết độ khó thực sự của một quyển sách, bạn phải đọc lướt qua nó. Nhưng chủ hiệu sách sẽ không vui nếu bạn đọc quá nhiều mà không mua, nên cô ấy chỉ cho phép bạn đọc lướt nhiều nhất \(S\) quyển. May thay, cô ấy cũng cho biết sách đã được sắp xếp theo độ khó tăng dần.
Hãy viết chương trình giúp bạn quyết định những quyển sách cần đọc lướt, rồi cuối cùng chỉ ra những quyển cần mua.
Đây là bài toán giao tiếp. Bạn phải cài đặt hàm sau:
void solve(int N, int K, long long A, int S);
Các tham số \(N\), \(K\), \(A\) và \(S\) có ý nghĩa như trên. Các độ khó \(x_1<x_2<\cdots<x_N\) ban đầu được giữ bí mật với chương trình. Với mỗi bộ dữ liệu, trình chấm gọi solve đúng một lần. Trong hàm này, bạn có thể gọi các hàm sau do trình chấm cung cấp:
long long skim(int i);
void answer(std::vector<int> v);
void impossible();
skim(i) đọc lướt quyển sách thứ \(i\) và trả về độ khó \(x_i\), với \(1\le i\le N\).answer(v) mua những quyển sách bạn chọn. Phải truyền \(v=\{i_1,\ldots,i_K\}\), trong đó \(1\le i_1,\ldots,i_K\le N\), các chỉ số \(i_j\) đôi một khác nhau và \(A\le x_{i_1}+\cdots+x_{i_K}\le2A\).impossible() khẳng định rằng không thể chọn một tập gồm \(K\) quyển sách có tổng độ khó mong muốn.Nếu tồn tại một cách chọn hợp lệ, bạn phải gọi answer đúng một lần. Nếu không, bạn phải gọi impossible đúng một lần. Chương trình tự động kết thúc sau khi gọi một trong hai hàm này.
Nếu bất kỳ lời gọi hàm nào không đúng định dạng trên, hoặc nếu bạn gọi skim quá \(S\) lần, chương trình lập tức bị kết thúc và nhận kết quả Not correct cho bộ dữ liệu đó. Không được ghi bất cứ thứ gì ra đầu ra chuẩn; nếu vi phạm, bạn có thể nhận kết quả Security violation!.
Nếu dùng C++, mã nguồn phải có #include "books.h". Để chạy thử trên máy, bạn có thể liên kết chương trình với sample_grader.cpp, được cung cấp trong phần đính kèm của bài trên CMS chính thức. Phần đính kèm còn có tệp cài đặt mẫu books_sample.cpp với các giải thích bổ sung. Nếu dùng Python, tệp mẫu books_sample.py trong phần đính kèm mô tả giao diện dành cho bài nộp Python.
Bài nộp nhận \(N\), \(K\), \(A\) và \(S\) qua tham số của solve, còn độ khó của từng quyển sách được truy vấn bằng skim.
Trình chấm mẫu nhận hai dòng từ đầu vào chuẩn. Dòng đầu chứa bốn số nguyên \(N\), \(K\), \(A\) và \(S\). Dòng thứ hai chứa \(N\) số nguyên \(x_1,x_2,\ldots,x_N\), là dãy độ khó tăng nghiêm ngặt.
Bài nộp đưa ra kết quả bằng answer hoặc impossible, không ghi ra đầu ra chuẩn.
Trình chấm mẫu ghi nhật ký tất cả các lời gọi hàm do chương trình thực hiện ra đầu ra chuẩn. Cuối cùng, nó ghi một trong các thông báo được mô tả trong phần “Trình chấm mẫu” dưới đây.
Xét một bộ dữ liệu có \(N=15\), \(K=3\), \(A=42\) và \(S=8\). Ban đầu, trình chấm gọi solve(15, 3, 42, 8). Sau đây là hai tình huống giao tiếp có thể xảy ra giữa chương trình và trình chấm. Trong các bản ghi, -> chỉ giá trị trả về của hàm; đó không phải là dữ liệu mà bài nộp cần in.
Tình huống thứ nhất:
skim(1) -> 1337
impossible()
Quyển sách đầu tiên, tức quyển dễ nhất, có độ khó \(1337\). Nhờ trực giác kỳ diệu, bạn quyết định rằng không có cách chọn hợp lệ. Kết luận đó đúng và được chấp nhận.
Tình huống thứ hai:
skim(1) -> 7
skim(15) -> 21
answer({11, 15, 7})
Quyển đầu tiên có độ khó \(7\) và quyển cuối cùng có độ khó \(21\). Vì dãy độ khó tăng nghiêm ngặt, nó chứa mọi số nguyên từ \(7\) đến \(21\). Mọi tập giá trị hợp lệ trong dãy có tổng từ \(42\) đến \(84\) đều được chấp nhận. Bạn trả lời bằng các chỉ số sách \(11,15,7\), tương ứng với độ khó \(17,21,13\). Cách chọn này đúng và được chấp nhận.
Các thông báo kết thúc của trình chấm mẫu có ý nghĩa như sau:
Invalid input.: dữ liệu được đưa vào trình chấm qua đầu vào chuẩn không đúng định dạng đã mô tả.Invalid skim.: skim được gọi với tham số không hợp lệ.Out of books to skim.: skim được gọi quá \(S\) lần.Invalid answer.: answer được gọi với tham số không hợp lệ.Wrong answer.: answer được gọi với một tập sách không thỏa yêu cầu.No answer.: solve kết thúc mà không gọi answer hay impossible.Impossible (not checked): s book(s) skimmed.: không xảy ra trường hợp lỗi nào ở trên, skim được gọi \(s\) lần và impossible đã được gọi. Trình chấm mẫu không kiểm tra kết luận không tồn tại cách chọn có đúng hay không.Correct: s book(s) skimmed.: không xảy ra trường hợp nào ở trên và skim được gọi \(s\) lần.Trình chấm dùng để đánh giá bài nộp chính thức chỉ đưa ra Not correct khi có lỗi hoặc Correct khi đúng. Cả trình chấm mẫu và trình chấm chính thức đều tự động kết thúc chương trình khi xảy ra một lỗi đã nêu hoặc khi chương trình gọi answer hay impossible.
Thời gian: \(1\) giây. Bộ nhớ: \(512\) MiB.
Ai mà ngờ sách khoa học máy tính lại có thể nhàm chán đến thế! Bạn chẳng học được bao nhiêu, còn tấm huy chương BOI thì ngày càng xa tầm với. Nhưng khoan đã — ai nói bạn phải giành huy chương một cách công bằng?1
Ban tổ chức BOI đã cho biết đề thi được cất trong một kho bí mật mà chỉ trưởng ban khoa học mới mở được, nên bạn không thể tiếp cận chúng. Tuy nhiên, lấy được dữ liệu kiểm thử trước cuộc thi có vẻ khả thi hơn, và chừng đó cũng đủ mang lại lợi thế.
Không may cho bạn, ban khoa học đã có biện pháp ngăn chặn gian lận. Họ chia dữ liệu kiểm thử thành \(N\) phần và phân phối chúng cho \(N\) máy chủ được đánh số từ \(1\) đến \(N\). Ban đầu, máy chủ \(i\) lưu phần dữ liệu \(i\). Các máy chủ được nối bằng \(N-1\) dây sao cho hai máy chủ bất kỳ đều được nối với nhau trực tiếp hoặc gián tiếp. Thỉnh thoảng, hai máy chủ chia sẻ dữ liệu: sau đó, cả hai cùng lưu chính xác những phần dữ liệu mà ít nhất một trong hai máy chủ đã lưu trước khi chia sẻ. Mỗi cặp máy chủ nối trực tiếp với nhau chia sẻ dữ liệu đúng một lần; các cặp không nối trực tiếp không chia sẻ dữ liệu với nhau.
Bạn được cho toàn bộ thứ tự các lần chia sẻ. Để phối hợp những lần xâm nhập, bạn muốn biết dữ liệu đang được phân bố như thế nào tại một số thời điểm giữa các lần chia sẻ. Cụ thể, bạn cần trả lời liệu một máy chủ có đang lưu một phần dữ liệu cho trước hay không, hoặc có bao nhiêu máy chủ đang lưu một phần dữ liệu cho trước.
Hãy viết chương trình trả lời các truy vấn đó khi biết thứ tự các lần chia sẻ và thời điểm của từng truy vấn.
Dòng đầu chứa hai số nguyên \(N\) và \(K\). Mỗi dòng trong \(N+K-1\) dòng tiếp theo có một trong các dạng sau:
S a b: máy chủ \(a\) và máy chủ \(b\) chia sẻ toàn bộ dữ liệu của chúng.Q a d: truy vấn xem máy chủ \(a\) hiện có lưu phần dữ liệu \(d\) hay không.C d: truy vấn số máy chủ hiện đang lưu phần dữ liệu \(d\).Có đúng \(N-1\) dòng bắt đầu bằng S và đúng \(K\) dòng bắt đầu bằng Q hoặc C.
Với mỗi truy vấn Q a d, in một dòng chứa yes nếu máy chủ \(a\) lưu phần dữ liệu \(d\) tại thời điểm truy vấn, hoặc no nếu không. Với mỗi truy vấn C d, in một dòng chứa một số nguyên là số máy chủ lưu phần dữ liệu \(d\) tại thời điểm truy vấn. In các câu trả lời theo thứ tự truy vấn; câu trả lời chỉ phụ thuộc vào những lần chia sẻ đã xảy ra trước truy vấn đó.
Trong mỗi phân nhóm, bạn nhận được \(50\%\) số điểm của phân nhóm đó nếu giải đúng tất cả các bộ dữ liệu không có truy vấn đếm số máy chủ lưu một phần dữ liệu, tức là không có dòng nào bắt đầu bằng C. Trên CMS, các bộ dữ liệu này được hiển thị là “Group 1” của phân nhóm tương ứng.
Ví dụ 1
6 9
S 1 2
S 1 3
S 3 4
Q 5 1
S 4 5
S 1 6
Q 5 1
Q 1 5
C 1
C 2
C 3
C 4
C 5
C 6
no
yes
no
6
6
5
3
2
2
Ví dụ 2
4 4
S 1 2
S 1 3
S 3 4
Q 2 1
Q 2 2
Q 2 3
Q 2 4
yes
yes
no
no
Thời gian: \(2\) giây. Bộ nhớ: \(512\) MiB.
À, chúng tôi nói thế, và các trưởng đoàn của bạn cũng vậy, nhưng thôi, cứ tiếp tục câu chuyện. ↩
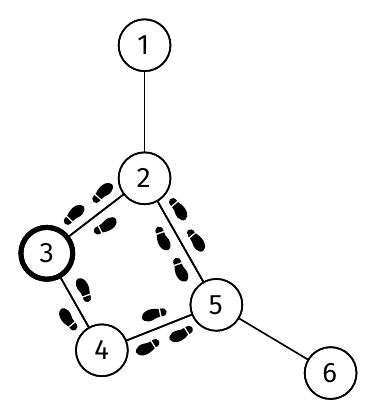
Không thể sống chỉ nhờ giải thưởng từ các cuộc thi tin học, bạn quyết định bước vào giới nghệ thuật — chính xác hơn là đột nhập một bảo tàng để bắt đầu sự nghiệp trộm tác phẩm nghệ thuật. Không may, bảo tàng này được canh gác khá cẩn mật: có \(K\) người bảo vệ đi tuần trong tòa nhà, mỗi người đi theo một đường khép kín đơn của riêng mình.
Để lên kế hoạch, bạn dùng một bản đồ mô tả bảo tàng bằng \(M\) hành lang nối \(N\) góc, được đánh số từ \(1\) đến \(N\). Bạn bắt đầu ở góc \(1\), còn mục tiêu — một hiện vật quý giá — nằm ở góc \(N\). Từ bất kỳ góc nào cũng có thể đi đến mọi góc khác, nhưng bạn chưa biết có thể đến mục tiêu mà không bị phát hiện hay không. Để không bị phát hiện, bạn không bao giờ được ở cùng một góc với người bảo vệ, cũng không được đi ngang qua một người bảo vệ trong hành lang.
May mắn thay, bạn đã lấy được lịch tuần tra nên biết vị trí ban đầu và lộ trình của từng người bảo vệ. Mỗi phút, người bảo vệ đi từ vị trí hiện tại đến góc tiếp theo trên lộ trình của mình; trong cùng khoảng thời gian đó, bạn có thể đứng yên hoặc đi đến một góc kề với góc hiện tại. Bạn nhận thấy lộ trình của hai người bảo vệ bất kỳ không có góc chung, và cả vị trí xuất phát lẫn mục tiêu của bạn đều không nằm trên bất kỳ lộ trình nào.
Hãy tính thời gian ít nhất, tính bằng phút, để đến mục tiêu an toàn mà không bị phát hiện, hoặc xác định rằng điều đó là không thể. Khi đến được hiện vật, bạn sẽ mở cửa sổ và rời bảo tàng bằng bộ đồ bay có cánh đã giành được trong cuộc thi tin học quốc gia, nên không cần lập kế hoạch cho đường quay về. Tất nhiên, là một tên trộm lịch thiệp, bạn sẽ không bao giờ đụng đến những người bảo vệ!
Dòng đầu chứa hai số nguyên \(N\) và \(M\). Mỗi dòng trong \(M\) dòng tiếp theo chứa hai số nguyên \(u\) và \(v\) (\(1\le u,v\le N\), \(u\ne v\)), cho biết có một hành lang nối trực tiếp góc \(u\) với góc \(v\). Giữa hai góc bất kỳ có nhiều nhất một hành lang nối trực tiếp.
Dòng tiếp theo chứa số nguyên \(K\). Tiếp theo là \(K\) dòng mô tả lộ trình của các người bảo vệ. Dòng thứ \(i\) bắt đầu bằng số nguyên \(\ell_i\), là số góc khác nhau trên lộ trình của người bảo vệ thứ \(i\), rồi đến \(\ell_i\) số nguyên đôi một khác nhau \(v_1,\ldots,v_{\ell_i}\), theo thứ tự người đó đi qua. Người bảo vệ bắt đầu tại \(v_1\), sau một phút đến \(v_2\), và cứ tiếp tục như vậy; sau \(\ell_i\) phút, người đó trở lại \(v_1\).
In một dòng chứa một số nguyên là thời gian ít nhất, tính bằng phút, để đến mục tiêu an toàn, hoặc chuỗi impossible nếu không có cách nào thực hiện được.
Ví dụ 1
6 6
1 2
2 3
3 4
4 5
5 2
5 6
1
4 3 2 5 4
4
Ví dụ 2
6 6
1 2
2 3
3 4
4 5
5 2
5 6
1
4 4 5 2 3
5
Bố trí bảo tàng giống ví dụ thứ nhất, nhưng vị trí xuất phát và chiều đi của người bảo vệ khác đi. Một cách đi tối ưu là lần lượt qua các góc \(1,2,3,4,5,6\).
Ví dụ 3
11 13
1 2
2 3
3 4
4 2
3 5
5 6
6 7
7 5
6 8
8 9
9 10
10 8
9 11
3
3 4 2 3
3 7 6 5
3 10 8 9
impossible
Thời gian: \(4\) giây. Bộ nhớ: \(512\) MiB.