APIO 2008

Bộ đề bài

# Bài tập Điểm Thời gian: Giới hạn bộ nhớ
1 APIO 2008 - Beads 100 (p) 2.0s 256M
2 APIO 2008 - Roads 100 (p) 1.0s 128M
3 APIO 2008 - DNA 100 (p) 1.0s 128M

1. APIO 2008 - Beads

Điểm: 100 (p) Thời gian: 2.0s Bộ nhớ: 256M Input: bàn phím Output: màn hình

Giáo sư X vừa giới thiệu phát minh mới nhất của mình: máy hoán đổi hạt tối thượng (UBS). Máy làm cho một dãy hạt trở nên thú vị hơn bằng cách đổi chỗ một số hạt!

UBS có \(N\) băng chuyền song song theo hướng bắc–nam, được đánh số từ \(1\) đến \(N\) từ trái sang phải. Tất cả băng chuyền chuyển động từ bắc xuống nam với cùng tốc độ. Có \(M\) bộ hoán đổi, mỗi bộ nằm giữa hai băng chuyền kề nhau. Không có hai bộ hoán đổi nào cách đầu phía bắc của máy một khoảng bằng nhau. Các bộ hoán đổi được đánh số từ \(1\) đến \(M\) theo thứ tự từ bắc xuống nam.
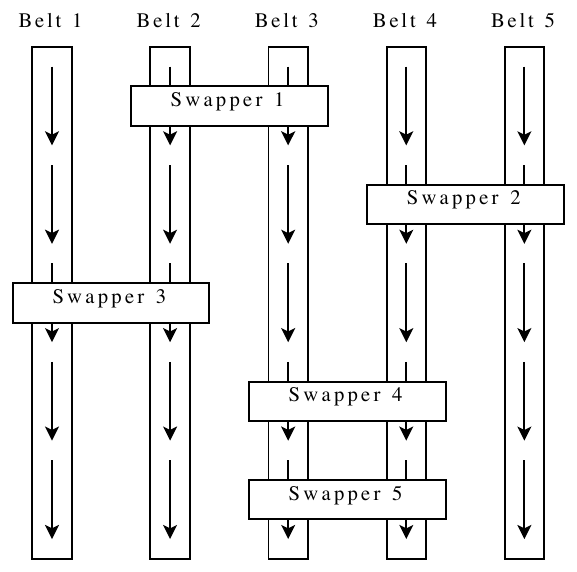
Để sử dụng máy, người ta đồng thời đặt \(N\) hạt tại đầu phía bắc, mỗi băng chuyền một hạt. Các hạt tạo thành một hàng ngang trong suốt quá trình chuyển động. Khi hai hạt đi tới một bộ hoán đổi, hạt trên băng chuyền bên phải được chuyển sang băng chuyền bên trái và ngược lại. Sau khi đổi chỗ, các hạt vẫn nằm trên cùng một hàng ngang. Chẳng hạn, nếu bốn hạt đang lần lượt ở trên bốn băng chuyền và bộ hoán đổi nối băng chuyền \(2\) với \(3\), thứ tự các hạt sau khi đi qua là \(1,3,2,4\).
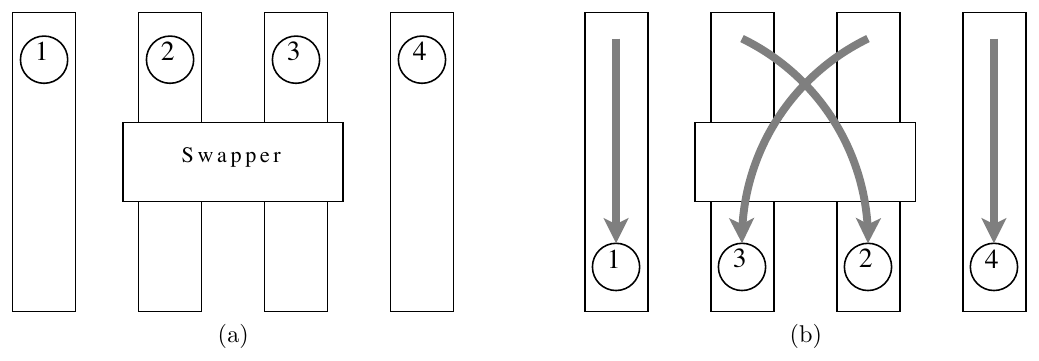
Cho cấu hình của máy, hãy trả lời các câu hỏi: hạt được đặt ban đầu trên băng chuyền \(K\) sẽ ở trên băng chuyền nào ngay sau khi hàng hạt đi qua bộ hoán đổi \(J\)?

Giao diện lập trình

Trên LQDOJ, giao diện thư viện tương tác của đề gốc được chuyển thành giao diện hàm tương đương dưới đây. Bạn nộp mã nguồn C++ (khuyến nghị C++17), chứa #include "beads.h", cài đặt hai hàm sau và không viết hàm main:

C++
void init(int N, int M, std::vector<int> P);
int ask(int K, int J);

Hàm init được bộ chấm gọi đúng một lần, trước mọi lời gọi ask. Hai tham số \(N,M\) lần lượt là số băng chuyền và số bộ hoán đổi. Vectơ P\(M\) phần tử; với \(0\le i<M\), bộ hoán đổi số \(i+1\) nối băng chuyền P[i]P[i]+1.

Sau đó, bộ chấm gọi ask đúng \(Q\) lần. Mỗi lời gọi cung cấp một câu hỏi \((K,J)\); hàm phải trả về số hiệu băng chuyền chứa hạt đó ngay sau bộ hoán đổi \(J\). Bạn phải trả lời câu hỏi hiện tại trước khi nhận câu hỏi tiếp theo. Không được đọc trước các câu hỏi, tự đọc dữ liệu vào hoặc tự ghi kết quả ra. Các câu hỏi không nhất thiết theo thứ tự tăng dần của \(J\).

Nội dung cần thiết của beads.h chính là hai khai báo hàm trong khối mã trên; hệ thống tự ghép tệp này và grader.cpp với mã nguồn của bạn khi chấm.

Dữ liệu vào

Định dạng dữ liệu dành cho bộ chấm thử:

  • Dòng đầu chứa hai số nguyên \(N,M\).
  • \(M\) dòng tiếp theo, dòng thứ \(i\) chứa vị trí \(P_i\) của bộ hoán đổi thứ \(i\), nối băng chuyền \(P_i\)\(P_i+1\).
  • Dòng tiếp theo chứa số câu hỏi \(Q\).
  • \(Q\) dòng tiếp theo, mỗi dòng chứa hai số nguyên \(K,J\) mô tả một câu hỏi.

Bộ chấm đọc cấu hình và gọi init, sau đó lần lượt đọc từng câu hỏi, gọi ask và ghi câu trả lời trước khi xử lý câu hỏi tiếp theo.

Dữ liệu ra

Bộ chấm thử ghi \(Q\) dòng, mỗi dòng là giá trị trả về của một lời gọi ask, theo thứ tự các câu hỏi.

Ràng buộc

\[ 1\le N\le 300\,000,\qquad 1\le M,Q\le 300\,000. \]
\[ 1\le P_i<N\ (1\le i\le M),\qquad 1\le K\le N,\qquad 1\le J\le M. \]

Giới hạn thời gian: \(2\) giây. Giới hạn bộ nhớ: \(256\) MB. Một bộ dữ liệu chỉ được tính điểm khi chương trình tuân thủ giao diện và trả lời đúng tất cả câu hỏi.

Phân nhóm

Mỗi phân nhóm được chấm độc lập theo kiểu tất cả hoặc không: bạn chỉ nhận điểm của nhóm khi đúng toàn bộ test trong nhóm. Điểm trong bảng là phần điểm cộng thêm trên LQDOJ; nhóm sau bao gồm lại các test thỏa điều kiện của nhóm trước.

Nhóm Điểm Ràng buộc bổ sung
1 20 \(M\le 10\,000\)\(Q\le 10\,000\)
2 80 Không có ràng buộc bổ sung

Ví dụ

Ví dụ 1

Input
5 5
2
4
1
3
3
2
3 4
5 5
Output
1
4
Note

Máy có năm băng chuyền. Các bộ hoán đổi lần lượt nối các cặp băng chuyền \((2,3)\), \((4,5)\), \((1,2)\), \((3,4)\)\((3,4)\). Bộ chấm gọi init(5, 5, {2, 4, 1, 3, 3}). Với câu hỏi đầu tiên, ask(3, 4) trả về \(1\): hạt xuất phát trên băng chuyền \(3\) nằm trên băng chuyền \(1\) sau bộ hoán đổi \(4\). Sau khi nhận câu trả lời này, bộ chấm gọi ask(5, 5), nhận \(4\): hạt xuất phát trên băng chuyền \(5\) nằm trên băng chuyền \(4\) sau bộ hoán đổi \(5\).

Nguồn

Olympic Tin học châu Á – Thái Bình Dương 2008, bài Beads.
2. APIO 2008 - Roads

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 128M Input: bàn phím Output: màn hình

Vương quốc Tân Á có \(N\) ngôi làng và \(M\) con đường nối các làng. Một số đường được lát đá, các đường còn lại được làm bằng bê tông. Việc duy trì các con đường miễn phí tốn rất nhiều tiền, nên vương quốc không thể giữ tất cả các con đường miễn phí và cần một kế hoạch mới.

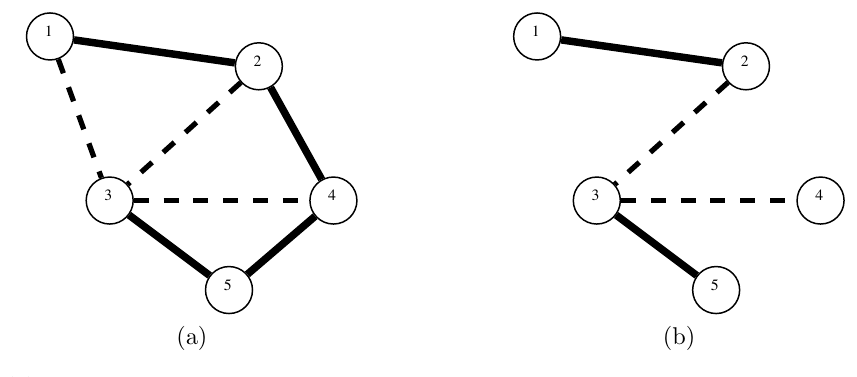
Nhà vua quyết định giữ số đường miễn phí ít nhất có thể, nhưng giữa mỗi hai ngôi làng phân biệt phải có đúng một đường đi chỉ sử dụng các con đường miễn phí. Mặc dù đường bê tông phù hợp với giao thông hiện đại hơn, nhà vua thấy đi trên đường lát đá rất thú vị. Vì vậy, ông yêu cầu giữ miễn phí đúng \(K\) con đường lát đá.

Hình dưới minh họa một mạng đường và một kế hoạch hợp lệ khi \(K=2\). Đường liền là đường bê tông, đường nét đứt là đường lát đá; hình bên phải chỉ vẽ các đường được giữ miễn phí.

Hãy xác định có kế hoạch nào thỏa mãn yêu cầu của nhà vua hay không. Nếu có, hãy đưa ra một kế hoạch hợp lệ.

Dữ liệu vào

Dòng đầu chứa ba số nguyên \(N,M,K\), lần lượt là số ngôi làng, số con đường và số đường lát đá cần được giữ miễn phí.

\(M\) dòng tiếp theo mô tả các con đường được đánh số từ \(1\) đến \(M\). Dòng thứ \(i\) trong số này chứa ba số nguyên \(u_i,v_i,c_i\): con đường thứ \(i\) nối hai làng \(u_i,v_i\); \(c_i=0\) nếu đó là đường lát đá và \(c_i=1\) nếu đó là đường bê tông.

Các ngôi làng được đánh số từ \(1\) đến \(N\). Không có quá một con đường nối cùng một cặp làng. Các con đường có thể đi theo cả hai chiều.

Dữ liệu ra

Nếu không có kế hoạch thỏa mãn, in no solution trên dòng đầu tiên.

Nếu có, liệt kê các con đường được giữ miễn phí, mỗi đường trên một dòng gồm ba số \(u_i,v_i,c_i\) mô tả đường đó như trong dữ liệu vào. Các con đường có thể được liệt kê theo thứ tự bất kỳ. Nếu có nhiều kế hoạch hợp lệ, bạn có thể in bất kỳ kế hoạch nào. Một kế hoạch hợp lệ gồm \(N-1\) con đường, nối tất cả các làng, không tạo chu trình và có đúng \(K\) đường lát đá.

Ràng buộc

\[ 1\le N\le 20\,000,\qquad 1\le M\le 100\,000,\qquad 0\le K\le N-1. \]
\[ 1\le u_i,v_i\le N,\qquad c_i\in\{0,1\}\quad (1\le i\le M). \]

Giới hạn thời gian: \(1\) giây. Giới hạn bộ nhớ: \(128\) MB. Một bộ dữ liệu chỉ được tính điểm khi kết quả hoàn toàn đúng.

Phân nhóm

Mỗi phân nhóm được chấm độc lập theo kiểu tất cả hoặc không: bạn chỉ nhận điểm của nhóm khi đúng toàn bộ test trong nhóm. Điểm trong bảng là phần điểm cộng thêm trên LQDOJ; nhóm sau bao gồm lại các test thỏa điều kiện của nhóm trước.

Nhóm Điểm Ràng buộc bổ sung
1 20 \(K\le 10\)
2 80 Không có ràng buộc bổ sung

Ví dụ

Ví dụ 1

Input
5 7 2
1 3 0
4 5 1
3 2 0
5 3 1
4 3 0
1 2 1
4 2 1
Output
3 2 0
4 3 0
1 2 1
5 3 1
Note

Có thể giữ miễn phí các đường \((1,2)\), \((2,3)\), \((3,4)\)\((3,5)\). Giữa mỗi hai làng có đúng một đường đi miễn phí, số đường được giữ miễn phí là ít nhất có thể, và có đúng hai đường lát đá là \((2,3)\)\((3,4)\).

Nguồn

Olympic Tin học châu Á – Thái Bình Dương 2008, bài Roads.

3. APIO 2008 - DNA

Điểm: 100 (p) Thời gian: 1.0s Bộ nhớ: 128M Input: bàn phím Output: màn hình

Một ứng dụng thú vị của máy tính là phân tích dữ liệu sinh học, chẳng hạn các chuỗi DNA. Về mặt sinh học, một sợi DNA là chuỗi các nucleotide Adenine, Cytosine, Guanine và Thymine, lần lượt được biểu diễn bằng các ký tự A, C, GT. Vì vậy, một sợi DNA có thể được biểu diễn bằng một xâu gồm bốn ký tự này, gọi là một chuỗi DNA.

Đôi khi các nhà sinh học không thể xác định một số nucleotide. Khi đó, ký tự N được dùng để biểu diễn một nucleotide chưa biết: nó có thể là bất kỳ một ký tự nào trong A, C, G, T. Một chuỗi có ít nhất một ký tự N được gọi là chuỗi chưa hoàn chỉnh; ngược lại, đó là chuỗi hoàn chỉnh. Một chuỗi hoàn chỉnh được gọi là phù hợp với chuỗi chưa hoàn chỉnh nếu có thể thu được nó bằng cách thay mỗi ký tự N bằng một trong bốn nucleotide. Chẳng hạn, ACCCT phù hợp với ACNNT, còn AGGAT thì không.

Các nucleotide được sắp thứ tự như trong bảng chữ cái tiếng Anh:

\[ \mathtt{A}<\mathtt{C}<\mathtt{G}<\mathtt{T}. \]

Một chuỗi DNA thuộc dạng 1 nếu mỗi nucleotide trong chuỗi bằng hoặc đứng trước nucleotide ngay bên phải nó theo thứ tự trên. Ví dụ, AACCGT thuộc dạng 1, còn AACGTC thì không.

Với \(j>1\), một chuỗi thuộc dạng \(j\) nếu nó thuộc dạng \(j-1\), hoặc là phép nối một chuỗi dạng \(j-1\) với một chuỗi dạng 1. Ví dụ, AACCC, ACACCACACA đều thuộc dạng 3, còn GCACACACACACA thì không.

Các chuỗi DNA được sắp theo thứ tự từ điển, như cách sắp các từ trong từ điển. Chẳng hạn, chuỗi dạng 3 đầu tiên có độ dài \(5\)AAAAA, và chuỗi cuối cùng là TTTTT. Với chuỗi chưa hoàn chỉnh ACANNCNNG, bảy chuỗi dạng 3 đầu tiên phù hợp với nó, theo thứ tự, là ACAAACAAG, ACAAACACG, ACAAACAGG, ACAAACCAG, ACAAACCCG, ACAAACCGGACAAACCTG.

Hãy tìm chuỗi dạng \(K\) đứng thứ \(R\) theo thứ tự từ điển trong số các chuỗi hoàn chỉnh phù hợp với chuỗi chưa hoàn chỉnh cho trước có độ dài \(M\). Thứ tự được đánh số bắt đầu từ \(1\).

Dữ liệu vào

Dòng đầu chứa ba số nguyên \(M,K,R\).

Dòng thứ hai chứa xâu độ dài \(M\) biểu diễn chuỗi chưa hoàn chỉnh, gồm các ký tự A, C, G, T, N.

Bảo đảm tổng số chuỗi dạng \(K\) phù hợp với chuỗi đã cho không vượt quá \(4\cdot 10^{18}\), và \(R\) không vượt quá tổng số này.

Dữ liệu ra

In trên một dòng chuỗi dạng \(K\) đứng thứ \(R\) phù hợp với chuỗi đã cho.

Ràng buộc

\[ 1\le M\le 50\,000,\qquad 1\le K\le 10,\qquad 1\le R\le 2\cdot 10^{12}. \]

Các giá trị lớn trong bài cần được lưu bằng kiểu số nguyên 64 bit: long long trong C/C++ hoặc Int64 trong Pascal. Trong C/C++, có thể đọc và ghi long long bằng scanf("%lld", &a)printf("%lld\n", a); Pascal không cần cách đọc, ghi đặc biệt cho Int64.

Giới hạn thời gian: \(1\) giây. Giới hạn bộ nhớ: \(128\) MB. Một bộ dữ liệu chỉ được tính điểm khi kết quả hoàn toàn đúng.

Phân nhóm

Mỗi phân nhóm được chấm độc lập theo kiểu tất cả hoặc không: bạn chỉ nhận điểm của nhóm khi đúng toàn bộ test trong nhóm. Điểm trong bảng là phần điểm cộng thêm trên LQDOJ; nhóm sau bao gồm lại các test thỏa điều kiện của nhóm trước.

Nhóm Điểm Ràng buộc bổ sung
1 20 \(M\le 10\)
2 80 Không có ràng buộc bổ sung

Ví dụ

Ví dụ 1

Input
9 3 5
ACANNCNNG
Output
ACAAACCCG

Ví dụ 2

Input
5 4 10
ACANN
Output
ACAGC

Nguồn

Olympic Tin học châu Á – Thái Bình Dương 2008, bài DNA.